از هوش مصنوعی خواستهاید فهرست تأمینکنندگان را از یک فایل بیرون بکشد و یک جدول تمیز تحویل گرفتهاید: همان ستونها، همان لحن مطمئن، و یک شمارهٔ تماس که در فایل اصلی اصلاً وجود ندارد. مشکل این نیست که مدل «بلد نبوده»؛ مشکل این است که وقتی بلد نبوده، بهجای سکوت، چیزی ساخته که قانعکننده به نظر میرسد. به این رفتار «توهم هوش مصنوعی» میگویند و هر کسی که از این ابزارها برای کار جدی استفاده میکند، دیر یا زود با آن روبهرو میشود.
خبر خوب این است که توهم یک اتفاق تصادفی و غیرقابلپیشبینی نیست. الگوی مشخصی دارد، در انواع مشخصی از کارها بیشتر رخ میدهد، و با چند تصمیم ساختاری ساده — نه با خرید ابزار گرانتر — تا حد زیادی مهار میشود. در ادامه میبینید توهم دقیقاً چیست، چرا رخ میدهد، کدام کارهای روزمرهٔ شما پرریسکاند، و چطور خروجی را طوری بخواهید که در چند ثانیه قابل راستیآزمایی باشد.
توهم هوش مصنوعی چیست؟
توهم هوش مصنوعی (AI Hallucination) یعنی مدل محتوایی تولید کند که روان، منسجم و ظاهراً درست است اما پشتوانهٔ واقعی ندارد: عددی که هیچ منبعی آن را تأیید نمیکند، نقلقولی که هرگز گفته نشده، شمارهٔ مادهٔ قانونی که وجود خارجی ندارد، یا لینکی که باز نمیشود.
تفاوت مهم توهم با «اشتباه» معمولی در همینجاست: وقتی یک ماشینحساب اشتباه میکند، معمولاً نتیجه بیربط و قابلتشخیص است. اما خروجی توهمی دقیقاً با همان لحن قاطع و همان قالب مرتبی نوشته میشود که خروجی درست. مدل نمیداند که نمیداند — و به همین دلیل هشدار نمیدهد.
شایعترین شکلهایی که در کار روزمره میبینید:
- عدد و آمار بدون منبع، با دقت مشکوک مثل «۳۷٫۴ درصد»
- ارجاع به قانون، مصوبه یا بند قرارداد با شمارهای که وجود ندارد
- نقلقول از یک فرد یا سازمان که آن جمله را نگفته است
- نام منبع، کتاب یا لینکی که باز نمیشود
- افزودهشدن ردیف یا ستونی به جدول که در فایل ورودی نبوده
- تبدیل اشتباه تاریخ، واحد یا ارز — بدون هیچ علامتی از تردید
چرا مدل بهجای گفتن «نمیدانم» جواب میسازد؟
مدل زبانی در هر گام، محتملترین کلمهٔ بعدی را پیشبینی میکند. هدف آموزشی آن تولید متنی است که شبیه متن درست باشد، نه الزاماً متنی که درست باشد. «نمیدانم» هم از نظر آماری یک جملهٔ کماحتمال است؛ متن کامل و مطمئن، محتملتر است.
به این نکته اضافه کنید که شیوهٔ ارزیابی مدلها سالها حدسزدن را تشویق کرده است: در آزمونی که پاسخ درست امتیاز میگیرد و «نمیدانم» امتیازی ندارد، مدلی که همیشه حدس میزند نمرهٔ بهتری میگیرد. پژوهشگران OpenAI هم در بررسی ریشهٔ توهم به همین سازوکار انگیزشی اشاره کردهاند.
در عمل، این عاملها احتمال توهم را بالا میبرند:
- پرسش دربارهٔ موضوعی که در دادهٔ آموزشی مدل نبوده یا بعد از آن رخ داده است
- نبود دسترسی به فایل یا منبع در لحظهٔ پاسخدادن
- پرامپت مبهم؛ مدل ناچار میشود جای خالی را خودش پر کند
- درخواست خروجی «کامل» — مثلاً جدولی با ده ردیف — وقتی منبع فقط شش ردیف دارد
- موضوع یا زبانی که حجم دادهٔ آموزشی کمی دارد
آیا در زبان فارسی توهم بیشتر رخ میدهد؟
در عمل بله، و دلیلش پیچیده نیست: حجم متن فارسیِ باکیفیت در دادهٔ آموزشی مدلهای عمومی در مقایسه با انگلیسی بسیار کمتر است. هرجا مدل دادهٔ کمتری دیده باشد، بیشتر به الگوسازی تکیه میکند و الگوسازی یعنی ساختن.
نقاطی که در کار فارسی بیشتر از بقیه میلغزند:
- تبدیل تاریخ شمسی و میلادی و محاسبهٔ فاصلهٔ روزها — راهنمای تاریخ شمسی در خروجیهای اداری این مورد را جداگانه بررسی کرده است
- اسامی خاص، نام شرکتها و برندهای ایرانی که املای نزدیک به هم دارند
- قوانین، بخشنامهها و رویههای اداری داخلی؛ اینجا مدل اغلب ساختار درست و محتوای ساختگی تولید میکند
- ارقام و واحد پول: جابهجایی ریال و تومان و حذف یا اضافهشدن یک صفر
- اصطلاحات صنفی که معادل انگلیسی رایجی ندارند و مدل آنها را «ترجمه» میکند
نتیجهٔ عملی این است که در کارهای فارسی، بازبینی نباید اختیاری باشد؛ باید بخشی از فرایند باشد — اما بازبینی هوشمندانه، نه بازخوانی کامل هر متن.
کدام کارها بیشتر در معرض توهماند؟
همهٔ کارها ریسک یکسانی ندارند. تفاوت اصلی یک چیز است: آیا منبعِ پاسخ در دسترس مدل هست یا مدل باید از حافظهاش بسازد؟
| نوع کار | ریسک توهم | چرا | کار درست |
|---|---|---|---|
| خلاصهسازی فایلی که ضمیمه کردهاید | کم | متن مرجع جلوی چشم مدل است | خلاصه را با تیترهای فایل تطبیق بدهید |
| بازنویسی، ویرایش و ترجمهٔ متن موجود | کم | چیزی برای ساختن وجود ندارد | واژههای تخصصی را چک کنید |
| استخراج داده از PDF و فاکتور اسکنشده | کم تا متوسط | خطای تشخیص رقم، نه ساختن رقم | چند ردیف را با تصویر اصلی مقابله کنید |
| آمار بازار، سهم بازار و عدد صنعتی | زیاد | مدل عدد را از حافظه بازسازی میکند | منبع را ضمیمه کنید یا عدد را حذف کنید |
| ارجاع به قانون، مصوبه یا مادهٔ قرارداد | خیلی زیاد | شمارهٔ ماده الگوی قابلتقلیدی دارد | متن قانون را ضمیمه کنید |
| فهرست منابع، لینک و مرجع | خیلی زیاد | ساختار لینک بهراحتی جعل میشود | هر لینک را باز کنید |
اگر کار شما در دو ردیف آخر جدول قرار میگیرد، تغییر مدل مشکل را حل نمیکند؛ تغییر ساختار کار آن را حل میکند.
چطور جلوی پاسخ اشتباه را بگیریم؟
چهار قدم زیر بیشترین اثر را با کمترین هزینه دارند. ترتیبشان هم مهم است:
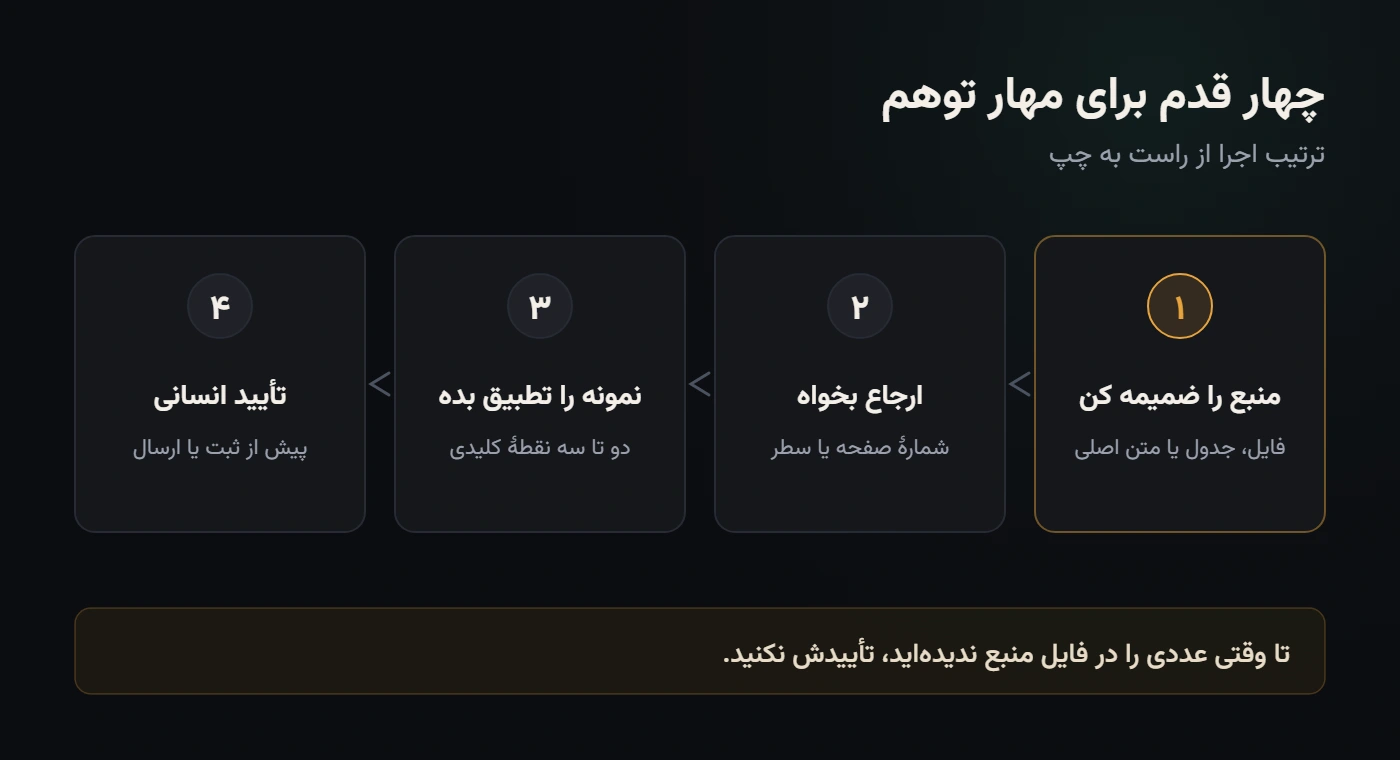
- منبع را ضمیمه کنید، نه اینکه از حافظهٔ مدل بخواهید. وقتی فایل، جدول یا سند اصلی در اختیار مدل باشد، بیشترین علت توهم حذف میشود. همین ایده در مقیاس سازمانی، اسمش RAG است: وصلکردن مدل به دانش خودتان بهجای اتکا به آنچه از قبل «بلد است».
- خروجی را قابلبررسی بخواهید. از مدل بخواهید کنار هر عدد یا ادعا، شمارهٔ صفحه، نام شیت یا عنوان بخش منبع را بیاورد. این کار هزینهای ندارد و بازبینی را از «خواندن کل متن» به «چککردن چند نقطه» تبدیل میکند.
- اجازهٔ «نمیدانم» را صریح بدهید. یک جملهٔ ساده در پرامپت — «اگر چیزی در منبع نبود، بنویس در منبع نیست و حدس نزن» — رفتار مدل را بهطور محسوسی تغییر میدهد. در راهنمای پرامپتنویسی فارسی نمونههای بیشتری از این الگو آمده است.
- کار را به مرحله بشکنید و نقطهٔ تأیید بگذارید. بهجای «گزارش را بنویس»، اول استخراج، بعد تطبیق، بعد نگارش. هر مرحله خروجی کوچکی دارد که در چند ثانیه قابل بررسی است — و خطا قبل از رسیدن به سند نهایی گرفته میشود.
برای اینکه تفاوت عملی این کار را ببینید، به دو پرامپت زیر برای یک کار کاملاً یکسان نگاه کنید:
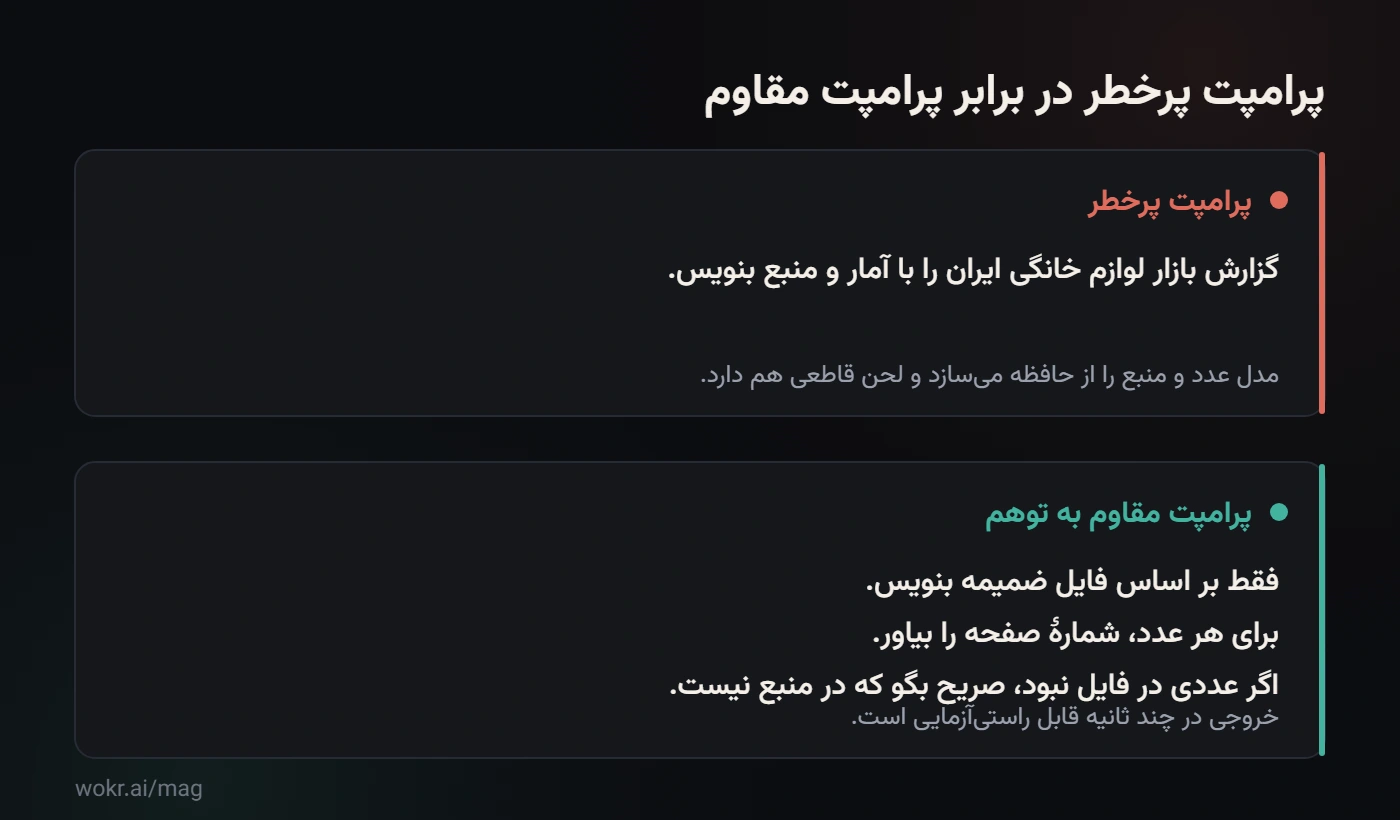
پرامپت دوم طولانیتر نیست که سختگیرانه باشد؛ طوری نوشته شده که اگر مدل اشتباه کند، شما بلافاصله متوجه شوید. این تفاوت اصلی بین یک خروجی قابلاستفاده و یک خروجی زیبا اما بیاعتبار است.
یک نکتهٔ جانبی اما مهم: ضمیمهکردن فایل یعنی فرستادن داده. پیش از اینکه اسناد مالی یا قراردادها را به هر ابزاری بدهید، ملاحظات امنیت داده در هوش مصنوعی سازمانی را مرور کنید.
چرا ایجنت کمتر از چتبات ساده دچار توهم میشود؟
این تفاوت ساختاری است، نه تبلیغاتی. یک چتبات متن تولید میکند؛ یک ایجنت ابزار اجرا میکند — فایل میخواند، جدول میسازد، خروجی تولید میکند. تفاوت در همین «ردپا»ی قابلبررسی است. اگر مرز این دو برایتان روشن نیست، تفاوت مدل زبانی و ایجنت را ببینید.
| معیار | چتبات سادهٔ متنی | ایجنت با ابزار |
|---|---|---|
| منبع پاسخ | حافظهٔ مدل | فایل، ابزار یا جستوجوی مشخص |
| قابلیت ردیابی | متن روان بدون ردپا | مرحلهها و ورودیها قابل مشاهدهاند |
| شکل خطای رایج | عدد و منبع ساختگی | انتخاب ابزار یا فایل اشتباه |
| هزینهٔ بازبینی برای شما | بازخوانی کل متن | بررسی چند نقطهٔ کلیدی |
| وقتی منبع ندارد | معمولاً میسازد | میتواند گزارش کند که داده پیدا نشد |
توجه کنید که ستون سوم «بدون خطا» نیست. ایجنت هم اشتباه میکند؛ اما اشتباهش معمولاً قابلدیدن است، و این تفاوت تعیینکنندهای است. استخراج داده از فایل — مثل کاری که در استخراج اطلاعات از PDF و فاکتور اسکنشده توضیح داده شده — دقیقاً به همین دلیل کمریسکتر از پرسیدن همان اطلاعات از یک چتبات است.
هر عدد، هر تاریخ و هر ارجاعی که در خروجی هوش مصنوعی میبینید، تا وقتی آن را در فایل منبع پیدا نکردهاید، یک پیشنهاد است — نه یک واقعیت.
قاعدهٔ طلایی
اشتباههای رایجی که توهم را بدتر میکنند
- پرسیدن «مطمئنی؟» — مدل معمولاً فقط لحنش را عوض میکند یا عقبنشینی میکند؛ این کار راستیآزمایی نیست.
- اعتماد به لحن قاطع. قاطعیت در خروجی مدل هیچ ارتباطی با درستی ندارد؛ هر دو نوع پاسخ یکجور نوشته میشوند.
- کپی مستقیم خروجی در سند رسمی. فاصلهای بین «خروجی مدل» و «سند نهایی» بگذارید، حتی اگر کوتاه باشد.
- حذف بازبینی چون دفعهٔ قبل درست بود. ریسک توهم به نوع کار وابسته است، نه به سابقهٔ موفقیت دیروز.
- سپردن کاری که اصلاً منبع ندارد. اگر خودتان هم نمیدانید عدد از کجا باید بیاید، مدل هم نمیداند.
پرسشهای پرتکرار
آیا توهم هوش مصنوعی کاملاً از بین میرود؟
نه. تا وقتی مدل بر پایهٔ پیشبینی احتمالی کار میکند، احتمال تولید محتوای بیپشتوانه صفر نمیشود. هدف واقعبینانه «حذف» نیست، «مهار و کشف سریع» است: طوری کار کنید که اگر توهمی رخ داد، پیش از رسیدن به سند نهایی دیده شود.
آیا RAG مشکل را حل میکند؟
تا حد زیادی کم میکند، اما تضمین نمیکند. اگر سند مرتبط بازیابی نشود یا سند خودش قدیمی باشد، مدل باز هم ممکن است جای خالی را پر کند. RAG ریسک را از «حافظهٔ مدل» به «کیفیت منبع شما» منتقل میکند — که کنترلش با شماست و همین مزیت اصلی آن است.
چطور بفهمم یک پاسخ اشتباه است؟
به سه چیز مشکوک شوید: عددی با دقت غیرمعمول، ارجاعی که شمارهٔ دقیق دارد، و هر ادعایی که «خیلی مناسب» به نظر میرسد. این سه را در منبع جستوجو کنید؛ اگر پیدا نشدند، خودِ نبودن پاسخ است.
آیا مدل گرانتر کمتر توهم میزند؟
مدلهای جدیدتر معمولاً در استدلال بهترند، اما این تفاوت در برابر «منبع داشتن یا نداشتن» کوچک است. یک مدل متوسط با فایل ضمیمه، تقریباً همیشه قابلاتکاتر از بهترین مدل بدون منبع است.
برای کارهای حقوقی و مالی اصلاً استفاده کنیم؟
بله، اما در نقش دستیار و نه مرجع. خلاصهسازی قرارداد ضمیمهشده، یافتن بندهای مشابه یا آمادهسازی پیشنویس کمریسک است؛ پرسیدن «قانون چه میگوید» بدون ضمیمهکردن متن قانون، پرریسکترین کاری است که میتوانید بکنید.
جمعبندی
توهم هوش مصنوعی نه یک باگ موقتی است و نه دلیلی برای کنار گذاشتن این ابزارها. یک ویژگی شناختهشده از نحوهٔ کار مدلهای زبانی است که با ساختاردادن به کار مهار میشود: منبع را ضمیمه کنید، ارجاع بخواهید، اجازهٔ «نمیدانم» بدهید و کار را به مرحلههای قابلبررسی بشکنید. تفاوت تیمهایی که از هوش مصنوعی نتیجهٔ واقعی میگیرند با بقیه، معمولاً در همین چهار تصمیم است — نه در ابزارشان.
اگر میخواهید این روش را روی یک کار واقعی امتحان کنید، سادهترین راه این است که یک فایل واقعی خودتان را به ایجنت بدهید و خروجی را با منبع مقابله کنید. پلن رایگان وکر ۱٬۰۰۰ توکن در هر ساعت میدهد و برای شروع به کارت بانکی نیاز ندارد؛ جزئیات اعتبار و هزینه را در صفحهٔ قیمتگذاری وکر ببینید.