یک پوشه روی سرور شرکت پر است از فاکتور اسکنشده، قرارداد امضاشده و رسید بانکی — و هیچکدام قابل جستوجو نیستند. برای پاسخ به یک سؤال ساده مثل «مجموع خرید ما از این تأمینکننده در تابستان چقدر بود؟» کسی باید فایلها را یکییکی باز کند، عددها را بخواند و در اکسل تایپ کند. این کار نه سخت است و نه مهارت خاصی میخواهد؛ فقط ساعتها وقت میبرد و دقیقاً روی حساسترین بخش — مبلغ و شمارهٔ حساب — خطا تولید میکند.
استخراج اطلاعات از PDF و تصویرهای اسکنشده همین فاصله را پر میکند. در این راهنما میبینید این کار دقیقاً یعنی چه، چرا نوع فایل همهچیز را تغییر میدهد، چرا بازشناسی نوری متن فارسی سختتر از انگلیسی است، با چه فرایند پنجگامی به جدولی میرسید که واقعاً میشود به آن تکیه کرد، و کجا هنوز باید یک انسان نگاه کند.
استخراج اطلاعات از PDF یعنی چه و چرا کپیکردن کافی نیست؟
پاسخ کوتاه: استخراج اطلاعات یعنی رسیدن از یک فایل که فقط برای «دیدهشدن» ساخته شده به دادهای که بتوانید رویش فیلتر بزنید، جمع بزنید و گزارش بگیرید. تفاوت اینجاست که کپیکردن متن، شما را فقط یک قدم جلو میبرد؛ چیزی که لازم دارید سه لایه است، نه یک لایه:
- متن: کاراکترها از فایل بیرون بیایند — چه از لایهٔ متنی فایل، چه با بازشناسی نوری از روی تصویر.
- ساختار: معلوم شود کدام عدد «مبلغ کل» است و کدام «مبلغ یک ردیف»، کدام تاریخ «تاریخ صدور» است و کدام «تاریخ سررسید».
- یکدستی: تاریخها یک قالب واحد بگیرند، عددها از جداکنندهٔ هزارگان پاک شوند و واحد پول در همهٔ ردیفها یکی باشد.
ابزارهای رایج «تبدیل عکس به متن» معمولاً فقط لایهٔ اول را انجام میدهند. به همین دلیل است که بعد از استفاده از آنها باز هم باید بنشینید و متن درهمریخته را دستی مرتب کنید. کار واقعی در لایهٔ دوم و سوم است.
فایل شما کدام نوع است؟ سه حالتی که مسیر کار را عوض میکند
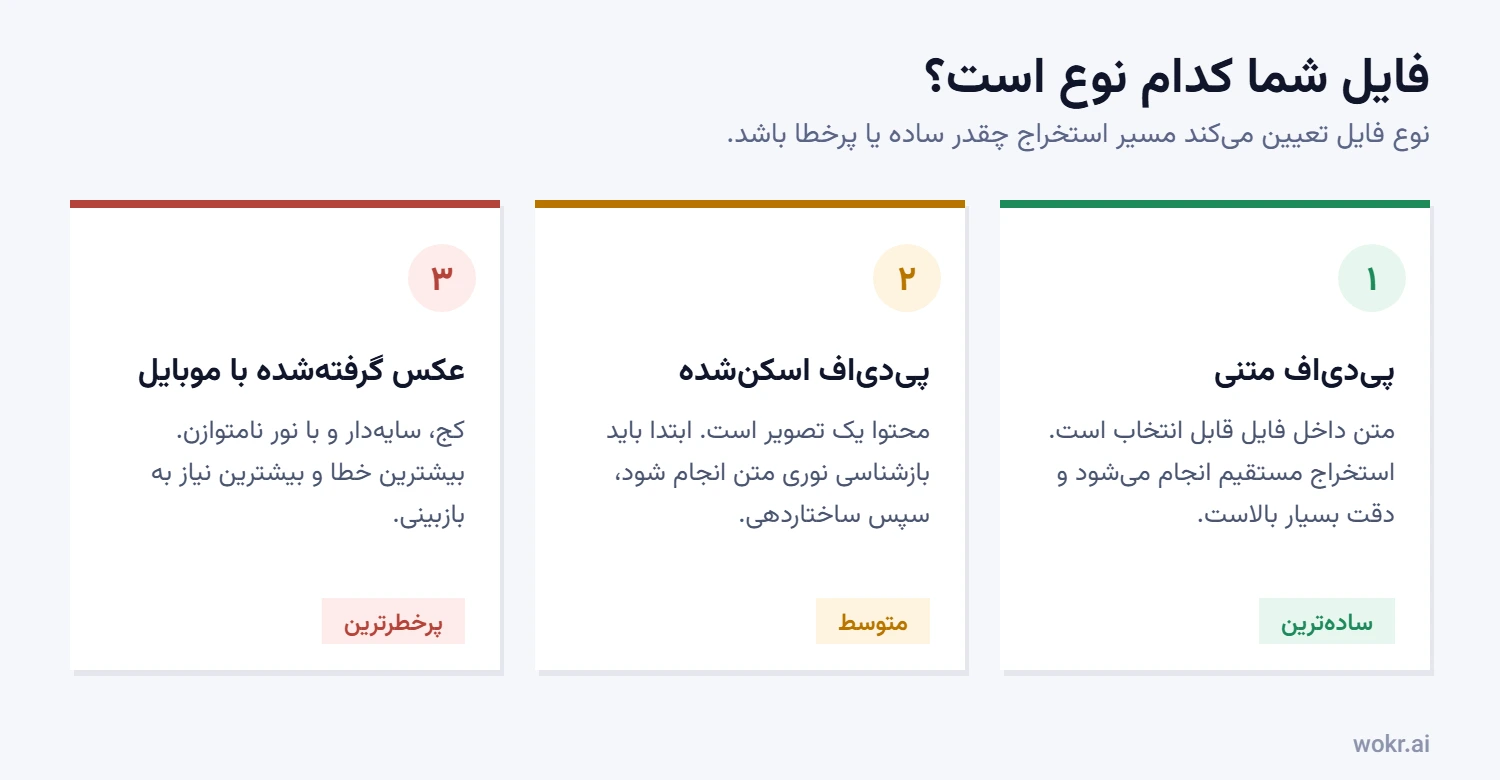
پیش از هر ابزاری، یک بررسی دهثانیهای انجام دهید: فایل را باز کنید و سعی کنید با ماوس روی متن آن درگ کنید. اگر متن انتخاب شد، فایل شما متنی است؛ اگر کل صفحه مثل یک عکس انتخاب شد، با یک اسکن طرف هستید. این تشخیص ساده، انتظار شما از دقت خروجی را واقعبینانه میکند.
| نوع فایل | داخل فایل چیست | سختی استخراج | کاری که باید بکنید |
|---|---|---|---|
| پیدیاف متنی | متن واقعی و قابل انتخاب | کم | مستقیم استخراج کنید؛ نیازی به بازشناسی نوری نیست |
| پیدیاف اسکنشده | تصویر صفحه | متوسط | اول بازشناسی نوری، بعد ساختاردهی به ستونها |
| عکس گرفتهشده با موبایل | تصویر کج، سایهدار یا کمنور | زیاد | صاف و روشن کنید، بعد استخراج و بازبینی بیشتر |
| فایل ترکیبی | چند صفحهٔ متنی کنار چند صفحهٔ اسکن | متغیر | صفحهبهصفحه تشخیص دهید؛ یک تنظیم برای کل فایل جواب نمیدهد |
چرا بازشناسی متن فارسی سختتر از انگلیسی است؟
اگر تجربهٔ ناامیدکنندهای با ابزارهای انگلیسی داشتهاید، تقصیر شما نبوده است. خط فارسی چند ویژگی دارد که کار موتورهای بازشناسی نوری را واقعاً دشوارتر میکند — و دانستنشان کمک میکند بدانید کجای خروجی را دقیقتر چک کنید:
- حروف چسبان: شکل هر حرف به موقعیتش در کلمه بستگی دارد. جداکردن حرفها از هم در یک اسکن کمکیفیت بهمراتب سختتر از الفبای لاتین است.
- نقطهها: تفاوت «ب»، «پ»، «ت» و «ث» فقط در نقطه است. یک لکهٔ جوهر یا فشردگی اسکن، اینها را به هم تبدیل میکند.
- ی و ک عربی: بسیاری از خروجیها «ي» و «ك» عربی تحویل میدهند. ظاهرشان تقریباً یکسان است، اما در اکسل و پایگاهداده جستوجو و تطبیق را خراب میکنند.
- سه دستگاه رقم: ارقام فارسی، ارقام عربی و ارقام لاتین در یک سند کنار هم دیده میشوند. اگر یکسانسازی نشوند، جمعزدن ستون مبلغ نتیجهٔ غلط میدهد.
- دوجهتیبودن متن: وقتی یک کد انگلیسی یا شمارهٔ حساب داخل جملهٔ فارسی میآید، ترتیب دیداری با ترتیب واقعی کاراکترها یکی نیست و متن میتواند در خروجی جابهجا کپی شود.
- مهر و امضا روی متن: مهر شرکت معمولاً دقیقاً روی مبلغ یا تاریخ میافتد و همان بخشی را میپوشاند که بیشترین اهمیت را دارد.
نتیجهٔ عملی این فهرست ساده است: تاریخها، اعداد و نامهای خاص سه جایی هستند که باید بیشترین توجه را به بازبینیشان بدهید. برای قالببندی درست تاریخ در خروجی نهایی، راهنمای تاریخ شمسی در اکسل و خروجیهای اداری دقیقاً همین مسئله را باز کرده است.
چطور از یک فایل اسکنشده به جدول اکسل قابلاعتماد برسیم؟
بیشتر شکستها از ضعف ابزار نیست؛ از نداشتن ترتیب است. این پنج گام، استخراج را از یک کار یکباره به فرایندی تبدیل میکند که ماه بعد هم میتوانید تکرارش کنید.
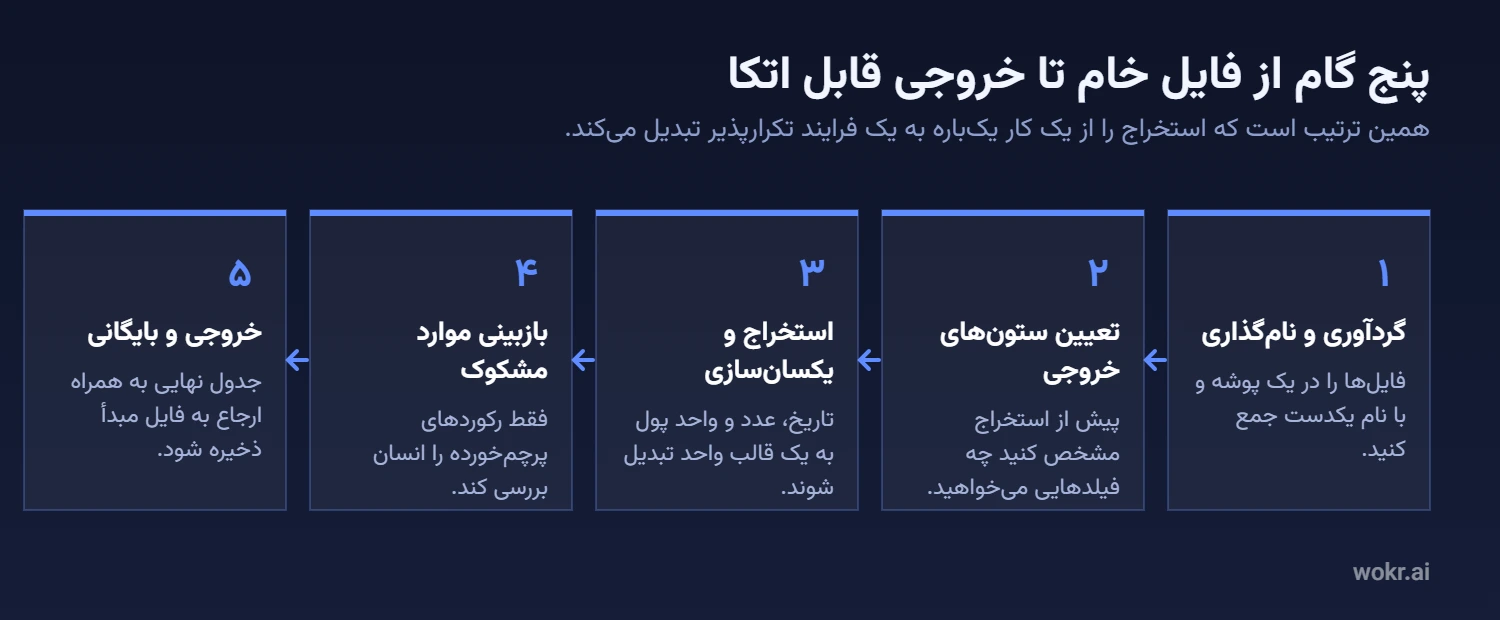
۱) فایلها را جمع و یکدست کنید
همه را در یک پوشه بگذارید و با یک الگوی ثابت نامگذاری کنید — مثلاً نام تأمینکننده و تاریخ. صفحههای چرخیده را بچرخانید و اسکنهای خیلی تیره را روشنتر کنید. ده دقیقه وقت در این مرحله، از یک ساعت اصلاح در مرحلهٔ آخر جلوگیری میکند.
۲) ستونهای خروجی را قبل از شروع تعریف کنید
این مهمترین گام است و معمولاً حذف میشود. دقیقاً بنویسید چه میخواهید: شمارهٔ فاکتور، تاریخ صدور، نام طرف حساب، شناسهٔ ملی، مبلغ پیش از مالیات، مالیات، مبلغ کل. هر فیلدی که از قبل تعریف نشود، در خروجی به شکلی متفاوت از هر فایل بیرون میآید و شما را به همان کار دستی برمیگرداند.
۳) استخراج و یکسانسازی را یک مرحله بدانید
در همان لحظهای که داده بیرون میآید، قالبش را هم تثبیت کنید: همهٔ تاریخها به یک تقویم و یک قالب، همهٔ اعداد بدون جداکنندهٔ هزارگان، همهٔ مبالغ به یک واحد — ریال یا تومان، اما فقط یکی. جداکردن این دو مرحله، بزرگترین منبع دوبارهکاری است.
۴) بهجای بازبینی همهچیز، موارد مشکوک را بازبینی کنید
بازبینی صد در صد خروجی، کل صرفهجویی را از بین میبرد. بهجایش قاعده بگذارید: هر ردیفی که مبلغ کلش با جمع ردیفها نمیخواند، هر تاریخی که خارج از بازهٔ منطقی است و هر فیلد خالی، پرچم بخورد. معمولاً بازبینی همین اقلیت، کیفیت را به حد قابلقبول میرساند. اگر خروجی قرار است با صورتحساب بانکی تطبیق داده شود، مغایرتگیری بانکی با هوش مصنوعی ادامهٔ طبیعی همین مرحله است.
۵) خروجی را همراه با ارجاع به فایل مبدأ ذخیره کنید
در جدول نهایی یک ستون بگذارید که نام فایل و شمارهٔ صفحهٔ مبدأ هر ردیف را نگه دارد. سه ماه بعد که کسی یک عدد را زیر سؤال میبرد، در چند ثانیه به سند اصلی میرسید بهجای اینکه کل پوشه را دوباره بگردید. از همین جدول میتوانید مستقیم به ساخت داشبورد اکسل با هوش مصنوعی برسید.
قاعدهٔ طلایی: تا وقتی ستونهای خروجی را ننوشتهاید، هنوز آمادهٔ شروع استخراج نیستید — ابزار نمیتواند حدس بزند شما کدام عدد را میخواهید.
تفاوت ابزار تبدیل عکس به متن با ایجنت هوش مصنوعی چیست؟
هر دو از یک نقطه شروع میکنند، اما در نقطهٔ پایان فرق دارند. ابزار بازشناسی نوری کارش را با تحویل متن تمامشده میداند؛ ایجنت متن را ورودی میگیرد و تا رسیدن به جدولی که شما تعریف کردهاید جلو میرود. اگر میخواهید بدانید این حلقه دقیقاً چطور کار میکند، تفاوت مدل زبانی و ایجنت همین تمایز را باز کرده است.
| معیار | ابزار بازشناسی نوری | ایجنت هوش مصنوعی |
|---|---|---|
| خروجی | متن پیوسته | جدول با ستونهای از پیش تعریفشده |
| درک نقش هر عدد | ندارد؛ فقط ترتیب دیداری | مبلغ کل را از مبلغ ردیف جدا میکند |
| یکسانسازی تاریخ و عدد | مرحلهٔ جداگانه و دستی | در همان مرحلهٔ استخراج |
| فایلهایی با قالب متفاوت | برای هر قالب تنظیم جدا | یک تعریف خروجی برای همه |
| اعلام تردید | ندارد | میتواند مورد مشکوک را پرچم بزند |
| کار بعدی روی داده | باید جای دیگری انجام شود | همانجا ادامه میدهد |
| مناسب برای | یک فایل، یکبار | کار دستهای و تکرارشونده |
برای یک فایل تکی، ابزار ساده کاملاً کافی است و اصراری به پیچیدهکردن نیست. صرفهٔ ایجنت وقتی پیدا میشود که هر ماه دهها فایل با قالبهای متفاوت دارید و خروجی باید همیشه یک شکل باشد. در وکر همین کار را میتوانید از وباپ یا از نسخهٔ ویندوز — که برای دستههای فایل محلی راحتتر است — انجام دهید.
کجا نباید به خروجی خودکار اعتماد کرد؟
پنهانکردن محدودیتها فقط انتظار را بالا میبرد و بعد اعتماد را از بین میبرد. اینها جاهایی است که هنوز باید یک انسان نگاه کند:
- هر عددی که مبنای پرداخت است. شمارهٔ شبا، شمارهٔ حساب و مبلغ نهایی را قبل از هر انتقال وجه چشمی تأیید کنید. یک رقم جابهجا، پول را جای دیگری میفرستد.
- دستخط. عدد یا امضای دستنویس روی فاکتور، بهویژه در فارسی، هنوز قابل اتکا نیست. آن را استثنا در نظر بگیرید، نه حالت عادی.
- بندهای حقوقی قرارداد. استخراج طرفین، مبلغ و تاریخها کار درستی است؛ اما تفسیر بند جریمه یا فسخ را به خروجی خودکار نسپارید. خلاصهسازی جلسات و قراردادها مرز این دو را روشنتر توضیح داده است.
- جدولهای با سلول ادغامشده یا چندصفحهای. وقتی یک جدول بین دو صفحه میشکند، احتمال جابهجایی ردیف بالا میرود. این فایلها را جدا کنید و جداگانه بررسی کنید.
- اسناد حاوی دادهٔ شخصی یا محرمانه. پیش از فرستادن پروندهٔ پرسنلی یا قرارداد محرمانه، سیاست داخلی خودتان را روشن کنید؛ امنیت داده در هوش مصنوعی سازمانی به همین تصمیم پرداخته است.
پرسشهای پرتکرار
آیا هوش مصنوعی میتواند دستخط فارسی را بخواند؟
تا حدی، و نه به اندازهای که بشود بدون بازبینی به آن تکیه کرد. متن چاپی فارسی روی اسکن تمیز نتیجهٔ خوبی میدهد، اما دستخط — بهخصوص اعداد دستنویس روی فاکتور — همچنان نیاز به تأیید انسانی دارد. آن را برای پرکردن سریع فرم به کار بگیرید، نه برای تأیید نهایی مبلغ.
استخراج اطلاعات از هر فایل چقدر هزینه دارد؟
هزینه به تعداد صفحه، کیفیت اسکن و حجم فیلدهایی که میخواهید بستگی دارد، پس عدد ثابتی برایش وجود ندارد. روش درست این است که اول با چند فایل نمونه تست کنید و مصرف واقعی خودتان را ببینید. طرح رایگان وکر ۱٬۰۰۰ توکن در ساعت میدهد و برای این تست کارت بانکی نمیخواهد؛ جزئیات بستهها هم در صفحهٔ تعرفهها آمده است و اعتبار خریداریشده تاریخ انقضا ندارد.
خروجی را چطور به اکسل یا نرمافزار حسابداری ببرم؟
اگر در گام دوم ستونها را دقیقاً تعریف کرده باشید، خروجی مستقیماً به شکل جدول در میآید و انتقالش به اکسل یک کپی ساده است. برای ورود به نرمافزار حسابداری، ابتدا ترتیب و نام ستونها را با قالب ورودی همان نرمافزار تطبیق دهید؛ هوش مصنوعی در حسابداری این مسیر را کاملتر شرح داده است.
اگر مهر و امضا روی متن فاکتور افتاده باشد چه؟
هر بخشی که زیر مهر پنهان شده باشد، قابل بازیابی نیست — نه با هوش مصنوعی و نه با هیچ ابزار دیگری. راهحل عملی این است که چنین ردیفهایی بهجای حدسزدن، خالی و پرچمدار بمانند تا در بازبینی از روی سند کاغذی تکمیل شوند.
برای فاکتورهایی که خودمان صادر میکنیم هم همین مسیر را برویم؟
نه. برای اسنادی که خودتان تولید میکنید، داده از ابتدا در دست شماست و نیازی به استخراج نیست؛ آنجا مسئله ساختن خروجی درست است، نه خواندن آن. ساخت فاکتور رسمی و گزارش مالی با هوش مصنوعی دقیقاً همان سمت ماجراست.
جمعبندی
استخراج اطلاعات از PDF وقتی جواب میدهد که آن را یک فرایند ببینید، نه یک دکمه. اول نوع فایل را تشخیص دهید، بعد ستونهای خروجی را بنویسید، استخراج و یکسانسازی را با هم انجام دهید، فقط موارد مشکوک را بازبینی کنید و در پایان ارجاع به سند مبدأ را نگه دارید. با همین ترتیب، کاری که امروز یک بعدازظهر از تیم شما میگیرد به چند دقیقه کار و یک بازبینی کوتاه تبدیل میشود — و مهمتر اینکه ماه بعد هم قابل تکرار است.
اگر میخواهید روی فایلهای واقعی خودتان امتحانش کنید، چند فاکتور نمونه را در وکر بدهید و ستونهایی را که میخواهید مشخص کنید؛ شروع رایگان است و کارت بانکی نمیخواهد. برای دیدن بستههای اعتباری و پرداخت ریالی هم صفحهٔ تعرفهها را ببینید.