یک آگهی استخدام برای یک نقش کاملاً معمولی میزنی و تا آخر هفته ۲۰۰ رزومه در صندوق ورودی داری. نصفشان اصلاً به آن نقش نمیخورند، یکسومشان انگار از روی هم نوشته شدهاند، و چند نفری که واقعاً میارزید ببینیشان جایی وسط اسکرول پنجاهم گم میشوند. مشکل، کمبود وقت نیست؛ مشکل این است که خواندن رزومهٔ صدم با همان دقتِ رزومهٔ اول، از عهدهٔ هیچ آدمی برنمیآید.
پاسخ کوتاه این است: غربال رزومه با هوش مصنوعی جای تصمیم تو را نمیگیرد، فقط ترتیب خواندن را عوض میکند. ایجنت متن رزومهها را استخراج میکند، به ساختاری یکسان میآورد و بر اساس معیارهایی که تو تعریف کردهای رتبه میدهد — با شاهدی از متن برای هر امتیاز. در ادامه میبینی این فرایند از چه مرحلههایی ساخته میشود، معیارها را چطور وزن بدهی، رزومههای فارسی و اسکنشده کجا کار را خراب میکنند و کدام اشتباهها گران تمام میشوند.
غربال رزومه با هوش مصنوعی دقیقاً یعنی چه؟
خیلیها این عبارت را با «سیستمی که خودش داوطلب را رد میکند» اشتباه میگیرند. کاری که یک ایجنت هوش مصنوعی در این فرایند انجام میدهد سه چیز است، نه بیشتر:
- خواندن و استخراج: باز کردن فایلهای PDF، ورد، عکس و متن ایمیل و بیرون کشیدن نام، سابقه، مهارتها، تحصیلات و تاریخها از دلِ قالبهای بههمریخته.
- یکسانسازی: تبدیل «کارشناس ارشد توسعهٔ نرمافزار»، «سنیور دولوپر» و «Senior Developer» به یک عنوان استاندارد، و تبدیل تاریخ شمسی و میلادی به یک مقیاس واحد تا مدت سابقه قابل مقایسه شود.
- رتبهبندی همراه با دلیل: دادن امتیاز به هر رزومه بر اساس معیارهای وزندار، بههمراه جملهای از خودِ رزومه که آن امتیاز را توجیه میکند.
تفاوت اصلی با فیلترهای کلیدواژهای همینجاست: فیلتر کلیدواژهای اگر واژهٔ «پایتون» را نبیند رد میکند، حتی اگر داوطلب نوشته باشد «سه سال توسعهٔ بکاند با Django». مدل زبانی این نسبت را میفهمد — اما برخلاف فیلتر، همیشه قابل پیشبینی نیست، و مهارِ همین بیثباتی کار توست.
فرایند غربال رزومه از کجا شروع میشود؟
اگر بخواهی از روز اول درست بسازیاش، شش مرحله دارد. سه مرحلهٔ میانی را میشود خودکار کرد؛ سه مرحلهٔ دیگر باید دست آدم بماند:
- شرح شغل ساختاریافته بنویس. پیش از هر چیز، معیارها، وزن هرکدام و «حداقلهای الزامی» را روی کاغذ بیاور. اگر این مرحله مبهم باشد، هیچ ابزاری نجاتت نمیدهد.
- رزومهها را یکجا جمع کن. ایمیل، فرم سایت، پیامرسان — همه در یک پوشه، با یک قاعدهٔ نامگذاری ثابت.
- متن را استخراج کن. فایلهایی که متنشان بیرون نمیآید (اسکن، عکس) را جدا کن و علامت بزن؛ رهایشان نکن.
- داده را نرمال کن. عنوان شغلی، مهارت، مدت سابقه و تاریخها را به قالب واحد ببر.
- امتیاز بده و دلیل بخواه. خروجی باید برای هر داوطلب هم عدد داشته باشد، هم شاهد متنی.
- خودت بازبینی کن. فهرست کوتاه را بخوان و — مهمتر — نمونهای تصادفی از رزومههای امتیازپایین را هم بخوان.
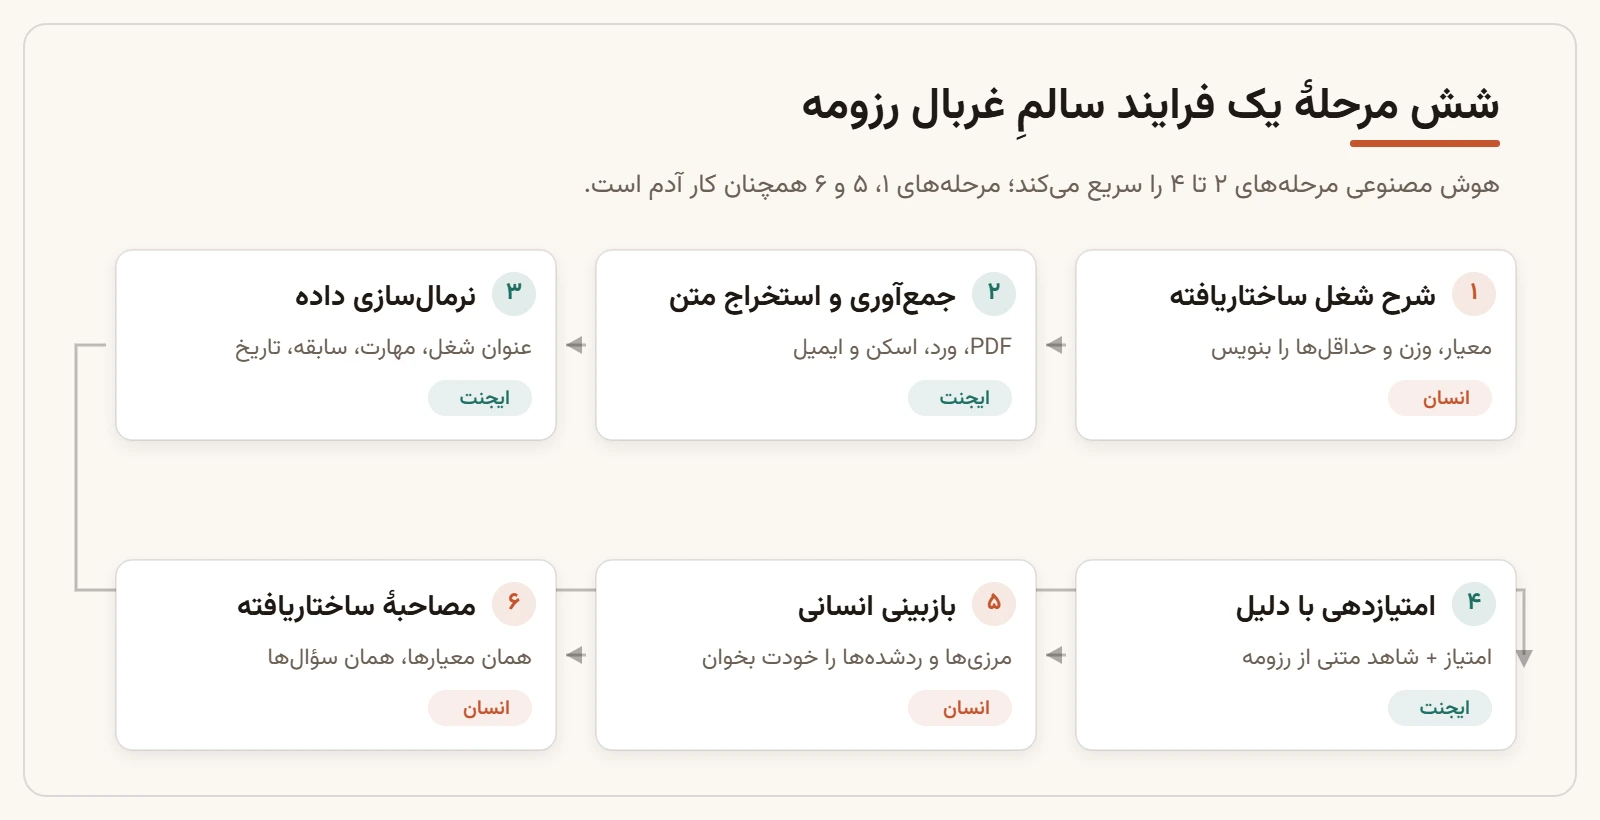
اگر حجم رزومهها زیاد است، میتوانی هر مرحله را به یک ایجنت جدا بسپاری تا خطای یک مرحله به مرحلهٔ بعد سرایت نکند؛ منطق این تقسیم کار را در مقالهٔ مولتیایجنت چیست مفصل توضیح دادهایم. برای یک آگهی با چند ده رزومه، یک ایجنت با دستور دقیق کافی است.
معیارهای امتیازدهی را چطور تعریف کنیم؟
بیشتر شکستها در این فرایند از ابزار نمیآید، از معیار مبهم میآید. «تجربهٔ کافی» یک معیار نیست؛ «حداقل سه سال کار تماموقت روی همین مسئولیت، با نمونهٔ قابل ارجاع» یک معیار است. جدول زیر یک نقطهٔ شروع منطقی برای نقشهای تخصصی است — وزنها را متناسب با شغل خودت جابهجا کن:
| معیار | وزن پیشنهادی | شاهدی که باید از رزومه بیرون بیاید | خطر اصلی |
|---|---|---|---|
| حداقلهای الزامی | دروازه (رد/قبول) | مدرک، مجوز، شهر، امکان حضور | سختگیری بیمورد و حذف افراد خوب |
| مهارتهای کلیدی نقش | ۳۰٪ | نام ابزار یا حوزه در دلِ یک تجربهٔ واقعی | اشتباهگرفتن نامبردن با بلد بودن |
| سابقهٔ مرتبط | ۲۵٪ | مدت و نوع مسئولیت، نه صرفاً عنوان شغلی | عنوانهای شغلی بزرگ اما توخالی |
| دستاورد قابلسنجش | ۲۰٪ | عدد، بازهٔ زمانی یا نتیجهٔ مشخص | ادعای بدون شاهد |
| نمونهکار یا ارجاع | ۱۵٪ | لینک، مخزن کد، نمونهٔ منتشرشده | نبودِ نمونه در بعضی نقشها طبیعی است |
| تناسب موقعیت و همکاری | ۱۰٪ | شهر، نوع قرارداد، بازهٔ زمانی آزاد | تبدیلشدن به فیلتر سلیقهای |
یک نکتهٔ جدی: هرچه به توانایی انجام کار ربط ندارد باید از معیارها بیرون بماند — نام، جنسیت، سن، وضعیت تأهل، عکس و در بیشتر نقشها حتی نام دانشگاه. اگر اینها در ورودی بمانند، سوگیری از همانجا وارد امتیاز میشود و بعداً قابل ردیابی نیست. سادهترین راه، حذف این فیلدها پیش از امتیازدهی است.
قاعدهٔ طلایی: ایجنت هیچکس را رد نمیکند؛ فقط ترتیب خواندن تو را عوض میکند. تصمیمِ «نه» همیشه باید امضای یک آدم پای آن باشد.
قاعدهٔ طلایی غربال رزومه
چرا امتیاز بدون دلیل بیارزش است؟
اگر خروجی فقط یک عدد باشد، هیچ راهی نداری بفهمی آن عدد از کجا آمده. عدد بدون شاهد نه قابل بازبینی است، نه قابل دفاع — نه جلوی مدیر، نه جلوی داوطلبی که میپرسد چرا رد شده است. بنابراین در دستوری که به ایجنت میدهی صریح بخواه که برای هر معیار، جملهٔ متناظرش را از متن رزومه نقل کند و اگر شاهدی پیدا نکرد، بهجای حدسزدن، همان را اعلام کند.
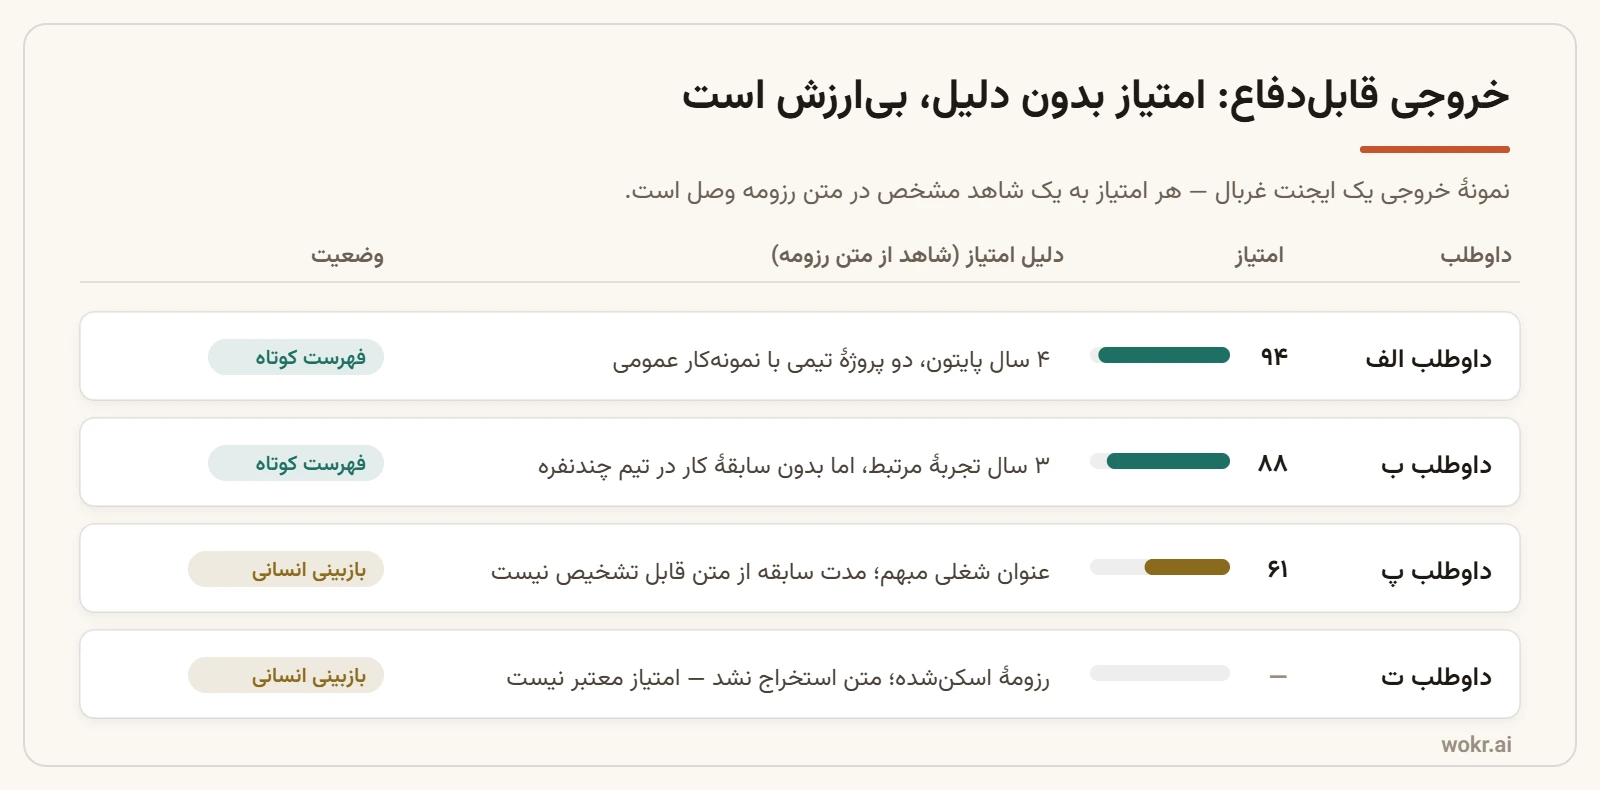
به دو ردیف پایین جدول دقت کن. وقتی ایجنت نمیتواند مطمئن باشد — عنوان شغلی مبهم است یا اصلاً متن فایل استخراج نشده — کار درست این نیست که امتیاز پایین بدهد؛ کار درست این است که پرچم «بازبینی انسانی» بزند. امتیاز پایین یعنی «بررسی شد و ضعیف بود»؛ اینها بررسی نشدهاند. قاطیکردن این دو، سریعترین راه از دست دادن آدمهای خوب است.
رزومههای فارسی و فایلهای اسکنشده چه دردسری میسازند؟
این بخش را بیشتر راهنماهای انگلیسی ندارند، ولی در عمل بیشترین وقت را همینجا از دست میدهی:
- فایل اسکنشده یا عکس رزومه: متنی برای استخراج وجود ندارد. یا باید از تشخیص نوری متن (OCR) استفاده کنی یا این فایلها را دستی بخوانی. حتماً جدایشان کن.
- تاریخ شمسی و میلادی کنار هم: «از ۱۴۰۰ تا ۲۰۲۳» در یک رزومه چیز نادری نیست. بدون یکسانسازی، محاسبهٔ مدت سابقه غلط از آب درمیآید.
- اعداد فارسی، عربی و لاتین: «۳ سال»، «٣ سال» و «3 سال» برای ابزار خام سه چیز متفاوتاند.
- نیمفاصله و املای ناهمگون: «نرمافزار»، «نرم افزار» و «نرمافزار» باید به یک شکل درآیند.
- عنوانهای شغلی غیراستاندارد: عنوانهایی مثل «مسئول امور» یا «کارشناس پروژه» بدون شرح وظایف، تقریباً هیچ اطلاعاتی ندارند. امتیاز را باید از شرح داد، نه از عنوان.
- جهت متن در فایلهای ترکیبی: رزومههای دوزبانه گاهی هنگام استخراج، ترتیب کلمات لاتین در جملهٔ فارسی را بههم میریزند. خروجی استخراج را یک بار چشمی نگاه کن.
اگر همین حالا هم کارهای اداریات را با ایجنت پیش میبری، بخش زیادی از این یکسانسازی چیزی است که پیشتر در اتوماسیون اداری با هوش مصنوعی دربارهٔ آن نوشتهایم؛ همان قاعدهها اینجا هم برقرار است.
غربال دستی، فیلتر کلیدواژهای یا ایجنت هوش مصنوعی؟
| معیار | غربال کاملاً دستی | فیلتر کلیدواژهای | ایجنت هوش مصنوعی |
|---|---|---|---|
| سرعت برای ۲۰۰ رزومه | چند ساعت تا چند روز | دقایق | دقایق |
| درک جملههای طبیعی | کامل | ندارد | خوب، اما نه بیخطا |
| یکنواختی قضاوت | با خستگی افت میکند | کاملاً یکنواخت | یکنواخت، بهشرط ثابتبودن دستور |
| دلیل قابل ارائه | در ذهن بازبین میماند | فقط بود/نبود کلیدواژه | امتیاز بههمراه شاهد متنی |
| ریسک حذف آدم خوب | متوسط | بالا | پایین اگر بازبینی انسانی داشته باشی |
| هزینهٔ راهاندازی | صفر | نصب و پیکربندی سامانه | نوشتن دستور دقیق و چند بار آزمایش |
| مناسب برای | کمتر از ۳۰ رزومه | حداقلهای سخت مثل مدرک و شهر | حجم متوسط تا بالا با معیارهای کیفی |
در عمل بهترین ترکیب معمولاً دوتایی است: اول یک فیلتر ساده برای حداقلهای غیرقابلمذاکره، بعد ایجنت روی همان باقیمانده. اینطور هم هزینهٔ پردازش پایین میآید، هم دقت بالا میرود.
کدام اشتباهها این فرایند را خراب میکنند؟
- رد خودکار بدون چشم انسان. بزرگترین اشتباه. ایجنت مرتب میکند، تو رد میکنی.
- معیار مبهم، انتظار دقیق. اگر خودت نمیدانی دنبال چه میگردی، خروجی هم نمیداند.
- ندیدنِ ردشدهها. هفتهای چند رزومهٔ امتیازپایین را تصادفی بخوان. اگر بین آنها آدم خوبی پیدا کردی، ایراد از معیارهاست نه از داوطلب.
- اعتماد به سطحِ نگارش رزومه. حالا که نوشتن رزومه با هوش مصنوعی رایج شده، «رزومهٔ خوشساخت» دیگر نشانهٔ توانایی نیست. امتیاز را روی شواهد بگذار، نه روی روانبودن جملهها.
- تغییر دستور وسط کار. اگر نیمهٔ راه معیارها را عوض کنی، رتبهها با هم قابل مقایسه نیستند. از اول شروع کن.
- نگهداشتن رزومهها بدون سیاست حذف. رزومه دادهٔ شخصی است. از قبل تعیین کن چه مدت و کجا نگه میداری و چه زمانی پاک میشود.
اگر هنوز در انتخاب ابزار ماندهای، مقایسهٔ گزینههای موجود را در بهترین ابزار هوش مصنوعی فارسی آوردهایم؛ معیار اصلی برای این کار، کیفیت کار با فایلهای فارسی است، نه فهرست امکانات.
هزینه و حریم خصوصی را چطور مدیریت کنیم؟
هزینه به تعداد رزومه و طول هر فایل بستگی دارد، نه به تعداد آگهیها؛ و اگر فقط بخشهای لازم را به ایجنت بدهی نه کل فایل را، مصرف محسوس پایین میآید. پیش از هر تصمیمی روی ۱۰ رزومهٔ واقعی آزمایش کن و مصرف را ببین، بعد در عدد نهایی ضرب کن.
در وکر پلن رایگان ۱٬۰۰۰ توکن در هر ساعت میدهد و برای شروع به کارت بانکی نیاز نداری، پس همین آزمایش اولیه را میتوانی بدون هیچ هزینهای انجام دهی. پرداخت هم ریالی و از طریق درگاه ایرانی است، اعتبار خریداریشده تاریخ انقضا ندارد و اشتراک ماهانهٔ اجباری هم در کار نیست — که برای تیمهایی که فقط در فصل استخدام حجم کاری بالا دارند، تفاوت مهمی است. جزئیات بستهها را در صفحهٔ قیمتها ببین.
دربارهٔ حریم خصوصی صریح باشیم: رزومه دادهٔ شخصی داوطلب است. حداقل کار این است که در آگهی بنویسی رزومهها با ابزار خودکار مرتب میشوند، فیلدهای غیرمرتبط را پیش از پردازش حذف کنی و مدت نگهداری را مشخص کنی. برای سازمانهایی که اصلاً نمیتوانند داده را بیرون بفرستند، امکان استقرار on-premise و ساخت ایجنت اختصاصی با Agent Studio در بخش سازمانی وجود دارد.
پرسشهای پرتکرار
آیا هوش مصنوعی میتواند خودش داوطلب را رد کند؟
از نظر فنی بله، از نظر عملی نه. رد خودکار یعنی خطای مدل مستقیماً به سرنوشت یک نفر تبدیل میشود، بدون اینکه کسی آن را ببیند. الگوی درست این است که ایجنت فهرست را مرتب و پرچمگذاری کند و تصمیم نهایی — بهویژه «نه» — با یک آدم باشد.
رزومههای فارسی را درست میخواند؟
اگر فایل متنی باشد (PDF تولیدشده از ورد یا خود فایل ورد)، بله؛ کیفیت استخراج متن فارسی امروز قابل اتکاست. مشکل جای دیگری است: رزومههای اسکنشده و عکسها. برای اینها یا باید OCR اضافه کنی یا آنها را دستی بخوانی. توصیه میکنیم در همان فرم دریافت رزومه، فایل تصویری را نپذیری.
برای یک آگهی با ۲۰۰ رزومه چقدر هزینه دارد؟
عدد ثابتی نمیشود گفت، چون به طول رزومهها و میزان جزئیاتی که از ایجنت میخواهی بستگی دارد. راه درست تخمین این است: ۱۰ رزومهٔ واقعی خودت را پردازش کن، مصرف را ببین و در ۲۰ ضرب کن. با پلن رایگان و ۱٬۰۰۰ توکن در ساعت میتوانی همین نمونهگیری را بدون پرداخت انجام دهی.
اگر داوطلب رزومهاش را با هوش مصنوعی نوشته باشد چه؟
احتمالش زیاد است و بهخودیخود ایراد نیست. اما یعنی نباید به کیفیت نگارش امتیاز بدهی. معیارهایت را روی چیزهای قابلراستیآزمایی ببر: نمونهکار، عدد، مدت مشخص، ارجاع. بعد همانها را در مصاحبهٔ ساختاریافته بپرس؛ فاصلهٔ بین رزومه و پاسخ شفاهی، همانجا خودش را نشان میدهد.
چه دادههایی را نباید وارد ایجنت کنیم؟
کد ملی، شمارهٔ حساب، تصویر مدارک هویتی، و هر دادهای که برای ارزیابی توانایی شغلی لازم نیست. اگر داوطلب اینها را در رزومه گذاشته، پیش از پردازش حذفشان کن. این کار هم ریسک را کم میکند، هم مصرف را.
جمعبندی
غربال رزومه با هوش مصنوعی وقتی جواب میدهد که آن را «مرتبکنندهٔ صف» ببینی، نه «تصمیمگیرندهٔ استخدام». معیارها را خودت بنویس و وزن بده، برای هر امتیاز شاهد متنی بخواه، فایلهای استخراجنشده را جدا نگه دار و هفتهای چند رزومهٔ ردشده را خودت بخوان. با همین چهار قاعده هم وقت آزاد میکنی، هم تصمیمهایت قابل توضیح میمانند.
اگر میخواهی روی رزومههای واقعی خودت امتحانش کنی، از پلن رایگان شروع کن: بستهها و پلن رایگان وکر — بدون کارت بانکی، و کافی برای اینکه ببینی این فرایند برای تیم تو جواب میدهد یا نه.