از یک مدل زبانی عمومی میپرسید «سقف مرخصی استحقاقی در شرکت ما چند روز است؟» و پاسخی میگیرید که روان، قاطع و کاملاً اشتباه است. مدل آییننامهٔ داخلی شما را هرگز ندیده است؛ پس چیزی میسازد که شبیه پاسخ درست باشد. همین اتفاق ساده، ریشهٔ بخش بزرگی از شکست پروژههای هوش مصنوعی در سازمانهاست: مدل باهوش است، اما دربارهٔ شما چیزی نمیداند.
راهحل رایج این مسئله، RAG است. در این مقاله بدون اصطلاحبازی توضیح میدهیم RAG چیست، چطور کار میکند، چه تفاوتی با فاینتیونینگ دارد، چرا یک ایجنت بدون آن ناقص میماند و از کجا باید شروع کنید — همراه با نقطههایی که معمولاً در آنها شکست میخورد.
RAG چیست و چه مشکلی را حل میکند؟
RAG کوتاهشدهٔ Retrieval-Augmented Generation یا «تولید تقویتشده با بازیابی» است: روشی که در آن مدل زبانی، پیش از نوشتن پاسخ، ابتدا در منابع شما جستوجو میکند، مرتبطترین تکههای متن را بیرون میکشد و بعد پاسخ را از روی همانها میسازد.
تشبیه سادهاش این است: تفاوت یک کارشناس که از حافظه جواب میدهد با کارشناسی که پیش از جوابدادن، پروندهٔ مربوطه را از بایگانی برمیدارد و باز میکند. مدل در حالت دوم باهوشتر نشده؛ فقط دیگر مجبور نیست حدس بزند.
این روش سه مشکل مشخص را هدف میگیرد:
- توهمزنی (Hallucination): وقتی پاسخ باید از متن بازیابیشده بیرون بیاید، فضای ساختن اطلاعات جعلی بهشدت تنگتر میشود.
- دانش قدیمی: مدل تا تاریخ مشخصی آموزش دیده است. بخشنامهٔ هفتهٔ گذشتهٔ شما در آن نیست، ولی میتواند در پایگاه دانش باشد.
- نبودِ ارجاع: پاسخ بدون منبع، در کار جدی قابل استناد نیست. RAG میتواند بگوید این جمله از کدام سند و کدام بند آمده است.
نکتهٔ مهم این است که RAG مدل را «آموزش» نمیدهد. هیچ وزنی تغییر نمیکند. شما فقط در لحظهٔ پرسش، متن درست را جلوی مدل میگذارید.
RAG دقیقاً چطور کار میکند؟
فرایند در دو نیمه اتفاق میافتد: یک نیمه از قبل و یکبار انجام میشود، نیمهٔ دیگر در هر پرسش تکرار میشود.
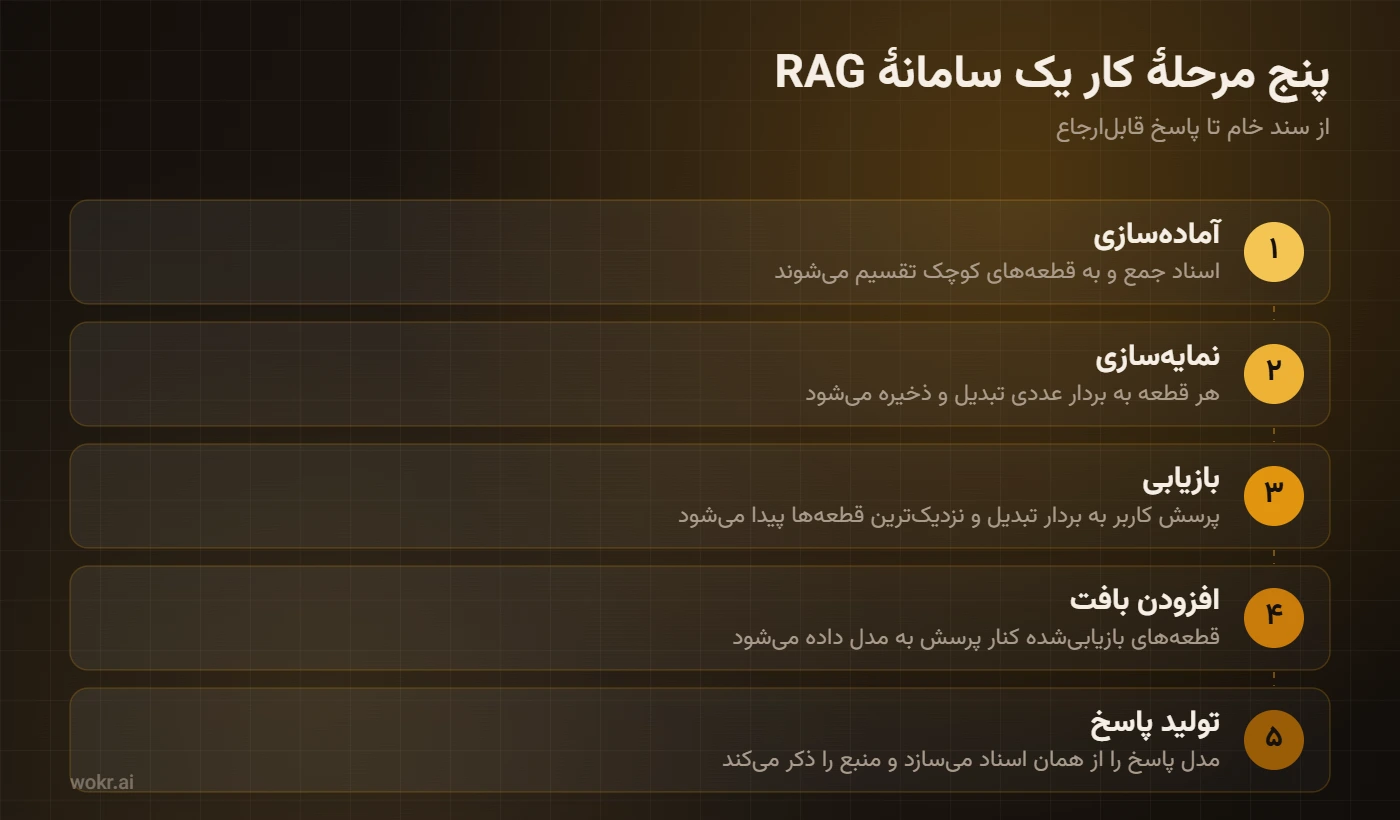
مرحلهٔ آمادهسازی (یکبار انجام میشود)
- جمعآوری و قطعهبندی: اسناد — آییننامهها، قراردادها، تیکتهای پشتیبانی، کاتالوگ محصول — جمع و به قطعههای چندصد کلمهای تقسیم میشوند. اندازهٔ قطعه مهم است: قطعهٔ خیلی بزرگ، بازیابی را بیدقت میکند و قطعهٔ خیلی کوچک، معنا را از بین میبرد.
- نمایهسازی برداری: هر قطعه به یک بردار عددی (Embedding) تبدیل میشود که «معنای» آن را نمایندگی میکند و در یک پایگاه دادهٔ برداری ذخیره میشود. به همین دلیل جستوجوی RAG با جستوجوی کلیدواژهای فرق دارد: «مرخصی بدون حقوق» میتواند سندی را پیدا کند که در آن نوشته شده «مرخصی استعلاجی غیرمزدی».
مرحلهٔ پاسخدهی (در هر پرسش تکرار میشود)
- بازیابی: پرسش کاربر هم به بردار تبدیل میشود و نزدیکترین قطعهها — معمولاً بین ۳ تا ۱۰ قطعه — از پایگاه دانش بیرون کشیده میشوند.
- افزودن بافت: آن قطعهها همراه با پرسش اصلی و یک دستور روشن («فقط بر اساس متن زیر پاسخ بده و اگر پاسخ در متن نبود، بگو نمیدانم») به مدل داده میشوند.
- تولید پاسخ: مدل پاسخ را از همان متن میسازد و میتواند شمارهٔ سند یا بند را ذکر کند.
کل این چرخه معمولاً کمتر از چند ثانیه طول میکشد و کاربر نهایی چیزی جز یک پاسخ مستند نمیبیند. کیفیت نوشتن پرسش هم بیتأثیر نیست؛ اگر با اصول پرامپتنویسی فارسی آشنا باشید، مرحلهٔ بازیابی هم نتیجهٔ بهتری میدهد.
تفاوت RAG با فاینتیونینگ و پنجرهٔ متن بلند چیست؟
این سه، رقیب هم نیستند؛ ابزارهایی برای سه مسئلهٔ متفاوتاند و اشتباه گرفتنشان مستقیماً هزینه تولید میکند.
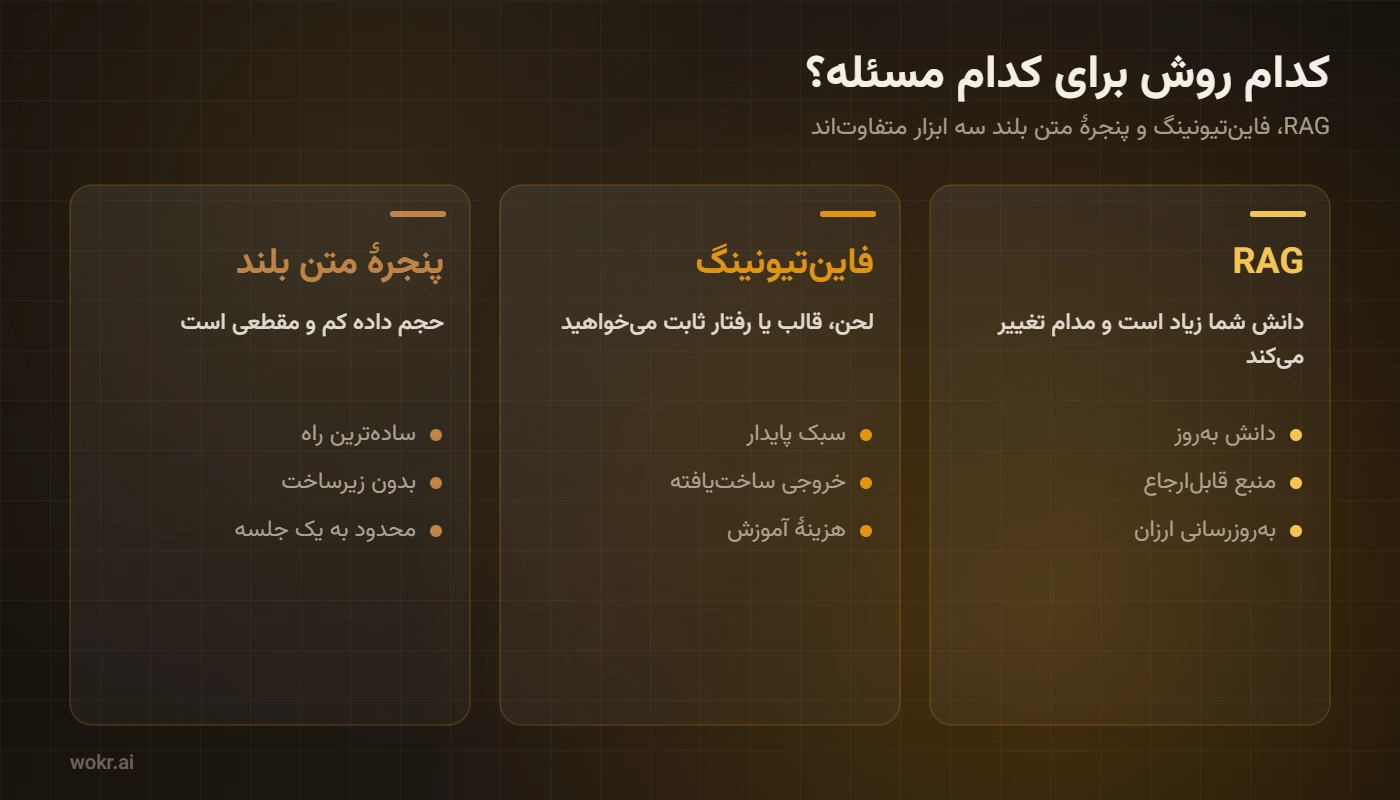
| معیار | RAG | فاینتیونینگ | پنجرهٔ متن بلند |
|---|---|---|---|
| چه چیزی را تغییر میدهد | متنی که به مدل داده میشود | وزنهای خود مدل | فقط محتوای همان گفتوگو |
| مناسب برای | دانش پرحجم و متغیر | تثبیت لحن، قالب و رفتار | دادهٔ کم و مقطعی |
| بهروزرسانی دانش | افزودن سند جدید به نمایه | آموزش دوباره | چسباندن دوبارهٔ متن |
| ارجاع به منبع | دارد | ندارد | محدود |
| هزینهٔ راهاندازی | متوسط | بالا | پایین |
| ضعف اصلی | وابسته به کیفیت بازیابی | دانش تازه را نمیگیرد | با حجم داده بزرگ نمیشود |
در عمل، بیشتر سازمانها با RAG شروع میکنند، چون دانششان هر هفته تغییر میکند و آموزش دوبارهٔ مدل برای هر بخشنامه منطقی نیست. فاینتیونینگ وقتی ارزش دارد که خروجی باید همیشه یک قالب یا لحن ثابت داشته باشد — و این دو میتوانند کنار هم استفاده شوند.
چرا ایجنت بدون RAG ناقص میماند؟
تفاوت یک ایجنت هوش مصنوعی با یک چتبات ساده در این است که ایجنت فقط حرف نمیزند؛ کار انجام میدهد: فایل میسازد، فرم پر میکند، داده استخراج میکند، چند مرحله را پشت سر هم پیش میبرد. اما هر تصمیمی که در این مسیر میگیرد، به دانستن یک چیز وابسته است.
ایجنتی که قرار است پیشفاکتور بنویسد، باید قیمتهای امروز شما را بداند نه قیمتهای عمومی بازار. ایجنتی که به تیکت مشتری پاسخ میدهد، باید شرایط گارانتی شما را بداند. بدون پایگاه دانش، ایجنت با اطمینان کار اشتباه انجام میدهد — و این از پاسخ اشتباه خطرناکتر است، چون خروجیاش وارد گردش کار میشود.
در معماریهای مولتیایجنت این وابستگی پررنگتر هم میشود: وقتی چند ایجنت خروجی همدیگر را مصرف میکنند، یک خطای کوچک در مرحلهٔ اول تا انتها بزرگ میشود. پایگاه دانش مشترک، همان چیزی است که همهٔ آنها را روی یک نسخه از واقعیت نگه میدارد. به همین دلیل در پروژههای اتوماسیون اداری، اتصال به دانش داخلی معمولاً پیشنیاز است، نه ویژگی تکمیلی.
چه دادهای را وارد پایگاه دانش کنیم و چه چیزی را نه؟
اشتباه رایج این است که تیمها کل درایو اشتراکی را یکجا وارد سامانه میکنند. نتیجه معمولاً بدتر از نقطهٔ شروع است، چون نسخههای قدیمی، پیشنویسهای رهاشده و فایلهای تکراری هم وارد نمایه میشوند و مدل با اطمینان از روی سند منسوخ جواب میدهد.
- خوراک خوب: آییننامهها و رویههای جاری، مستندات محصول، پرسشهای پرتکرار مشتریان، شرح خدمات، لیست قیمت بهروز، گزارشهای نهاییشده.
- خوراک بد: نسخههای قدیمی بدون تاریخ، پیشنویسهای تأییدنشده، رشتههای طولانی ایمیل، اسکنهای بیکیفیت بدون متن قابل استخراج.
- دادهٔ حساس: اطلاعات هویتی مشتریان، دادهٔ پزشکی، اطلاعات بانکی و کلیدهای دسترسی نباید بدون بررسی وارد هیچ سامانهای شوند — فرقی نمیکند سامانه داخلی باشد یا ابری.
برای سازمانهایی که دادهٔ حساس دارند و نمیخواهند اسناد از مرز شبکهٔ داخلی خارج شود، مسیر معمول استقرار on-premise است؛ یعنی همان معماری RAG، اما روی زیرساخت خودتان. در وکر این مسیر بههمراه Agent Studio برای ساخت ایجنت اختصاصی سازمان ارائه میشود — جزئیات و شرایطش را میتوانید در بخش سازمانی وکر ببینید.
قاعدهٔ طلایی: کیفیت پاسخ RAG هیچوقت از کیفیت اسنادی که به آن دادهاید بالاتر نمیرود. پیش از آنکه به فکر مدل بهتر باشید، بایگانیتان را مرتب کنید.
RAG کجا شکست میخورد؟
RAG جادو نیست و شکستهایش الگوی مشخصی دارند. شناختن این الگوها باعث میشود انتظارتان واقعبینانه بماند:
- بازیابی اشتباه، پاسخ اشتباه. اگر قطعهٔ درست پیدا نشود، مدل از روی قطعهٔ نامربوط جواب میسازد. بیشتر خطاهایی که به مدل نسبت داده میشوند، در واقع خطای مرحلهٔ بازیابیاند.
- پرسشهای جمعی و تحلیلی. «مجموع فروش سال گذشته چقدر بود؟» پرسشی نیست که با پیدا کردن چند قطعه متن پاسخ بگیرد؛ این کارِ پایگاه داده و ابزار محاسبه است، نه بازیابی معنایی.
- تضاد بین اسناد. وقتی دو سند حرف متفاوتی میزنند، مدل معمولاً یکی را انتخاب میکند بدون آنکه تضاد را گزارش کند. تاریخگذاری و حذف نسخههای منسوخ، مؤثرتر از هر تنظیم فنی است.
- توهمزنی کاملاً از بین نمیرود. کم میشود، اما صفر نمیشود. برای کارهای حقوقی و مالی، بازبینی انسانی همچنان لازم است.
- جدولها و فایلهای اسکنشده. جدولهای پیچیده در قطعهبندی خرد میشوند و معنایشان را از دست میدهند؛ اسکن بدون لایهٔ متنی هم عملاً برای نمایهسازی نامرئی است.
از کجا شروع کنیم؟ یک مسیر واقعبینانه
پروژههای RAG معمولاً وقتی شکست میخورند که از «همهٔ دانش سازمان» شروع میشوند. مسیر کمریسکتر، کوچک شروع کردن است:
- یک پرسش پرتکرار را انتخاب کنید. سؤالی که هر هفته چند بار از یک نفر مشخص پرسیده میشود — مثلاً شرایط مرجوعی کالا یا مراحل تسویهحساب.
- فقط اسناد همان موضوع را جمع کنید. ده تا بیست سند بهروز، از صد فایل نامرتب بهتر جواب میدهد.
- یک مجموعه پرسش آزمون بسازید. بیست پرسش واقعی با پاسخ درستِ از پیش مشخص. این تنها راه سنجیدن پیشرفت است؛ بدون آن فقط حس شخصی باقی میماند.
- خروجی را با انسان بسنجید. تا وقتی دقت روی آن بیست پرسش قابل قبول نشده، دامنه را گسترش ندهید.
- بعد به ایجنت وصلش کنید. وقتی پاسخها قابل اعتماد شدند، همان دانش را در اختیار ایجنتی بگذارید که کار واقعی انجام میدهد.
اگر میخواهید پیش از هر تصمیم زیرساختی، رفتار یک ایجنت را روی نمونهٔ کوچکی از اسناد خودتان ببینید، پلن رایگان وکر ۱٬۰۰۰ توکن در هر ساعت میدهد و برای شروع به کارت بانکی نیاز ندارد. اعتبارهای خریداریشده هم تاریخ انقضا ندارند و اشتراک ماهانهٔ اجباری در کار نیست؛ جزئیات را در صفحهٔ قیمتها ببینید.
پرسشهای پرتکرار
آیا برای RAG باید برنامهنویس باشم؟
برای ساختن زیرساخت از صفر، بله. اما بیشتر سازمانها امروز از ابزارهای آماده استفاده میکنند که در آنها «بارگذاری سند» و «پرسیدن» کار یک کاربر عادی است. کار فنی معمولاً در تنظیم دسترسیها و اتصال به سامانههای داخلی باقی میماند.
RAG با فارسی چطور کار میکند؟
مدلهای امروزی فارسی را قابل قبول پردازش میکنند، اما دو نکته تفاوت ایجاد میکند: یکنواختسازی نگارش (مثل «ی» و «ک» عربی در برابر فارسی) و کیفیت متن استخراجشده از PDF. اسنادی که متنشان در PDF درست انتخاب نمیشود، معمولاً برای نمایهسازی هم بیفایدهاند.
آیا RAG جلوی توهمزنی را کامل میگیرد؟
خیر. آن را بهشکل محسوسی کم میکند و مهمتر از آن، خطا را قابل ردیابی میکند: وقتی پاسخ به سند ارجاع دارد، میتوانید بررسی کنید که اشتباه از بازیابی بوده یا از برداشت مدل. برای تصمیمهای حقوقی و مالی، بازبینی انسانی همچنان لازم است.
وقتی مدلها پنجرهٔ متن بسیار بزرگ دارند، باز هم RAG لازم است؟
بله، در بیشتر موارد سازمانی. فرستادن کل بایگانی در هر پرسش، هم پرهزینه است و هم دقت را کاهش میدهد، چون مدل باید در حجم زیادی متن نامربوط دنبال نکتهٔ درست بگردد. پنجرهٔ بزرگ برای کار با چند سند مشخص عالی است، نه برای دانش دائمی سازمان.
دادهٔ ما محرمانه است؛ چه گزینهای داریم؟
دو مسیر متداول وجود دارد: محدود کردن دامنهٔ اسناد به بخشهای غیرحساس، یا استقرار on-premise تا داده از شبکهٔ داخلی خارج نشود. انتخاب بین این دو بیشتر از آنکه فنی باشد، تصمیم سیاستی و حاکمیت داده است.
جمعبندی
RAG پاسخ سادهای به یک مسئلهٔ ساده است: مدل زبانی دربارهٔ سازمان شما چیزی نمیداند، پس پیش از پاسخدادن باید سند درست را پیدا کند. این کار نه مدل را عوض میکند و نه نیاز به آموزش دوباره دارد؛ فقط زمینهٔ درست را در لحظهٔ درست فراهم میکند.
ارزش واقعیاش هم وقتی آشکار میشود که به یک ایجنت وصل شود — یعنی جایی که نتیجه بهجای متن، یک فاکتور، یک گزارش یا یک تصمیم اجرایی است. اما پیش از هر چیز، همان قاعدهٔ طلایی برقرار است: اول بایگانی، بعد هوش مصنوعی.
میخواهید ببینید یک ایجنت روی اسناد خودتان چه خروجیای میدهد؟ با پلن رایگان وکر بدون کارت بانکی شروع کنید و یک پرسش واقعی سازمانتان را امتحان کنید؛ و اگر دادهٔ حساس دارید، گزینهٔ استقرار داخلی و Agent Studio در بخش سازمانی در دسترس است.