ساعت یازده شب است. مشتریای که دیروز خرید کرده در سایت شما مینویسد «سفارشم کی میرسد؟» و جوابی که میگیرد این است: «برای پیگیری سفارش عدد ۱ را ارسال کنید.» عدد ۱ را میفرستد و دوباره همان منو برمیگردد. صبح روز بعد، کارشناس پشتیبانی شما همان پرسش را برای بیستمین بار جواب میدهد. هر دو طرف بازندهاند: مشتری حس میکند با دیوار حرف زده و تیم شما وقتش را صرف کاری کرده که هیچ ارزشی تولید نمیکند.
پشتیبانی مشتری با هوش مصنوعی راهحل همین وضعیت است — اما نه به آن شکلی که معمولاً تبلیغ میشود. پاسخ کوتاه این است: هوش مصنوعی باید پرسشهای تکراری و قابلپیشبینی را فوری جواب بدهد، برای موارد پیچیده پیشنویس بنویسد، و هر جا احتمال اشتباه پرهزینه وجود دارد بدون معطلی گفتگو را به یک کارشناس انسانی بسپارد. تفاوت یک تجربهٔ خوب با یک ربات آزاردهنده در همین تقسیم کار است، نه در قدرت مدل.
پشتیبانی مشتری با هوش مصنوعی دقیقاً چه کاری انجام میدهد؟
وقتی از هوش مصنوعی در پشتیبانی حرف میزنیم معمولاً فقط یک تصویر به ذهن میآید: ویجت گفتگو در گوشهٔ سایت. اما این تنها یکی از سه لایه است و اتفاقاً وقتی دو لایهٔ دیگر غایب باشند، کماثرترین لایه هم هست.
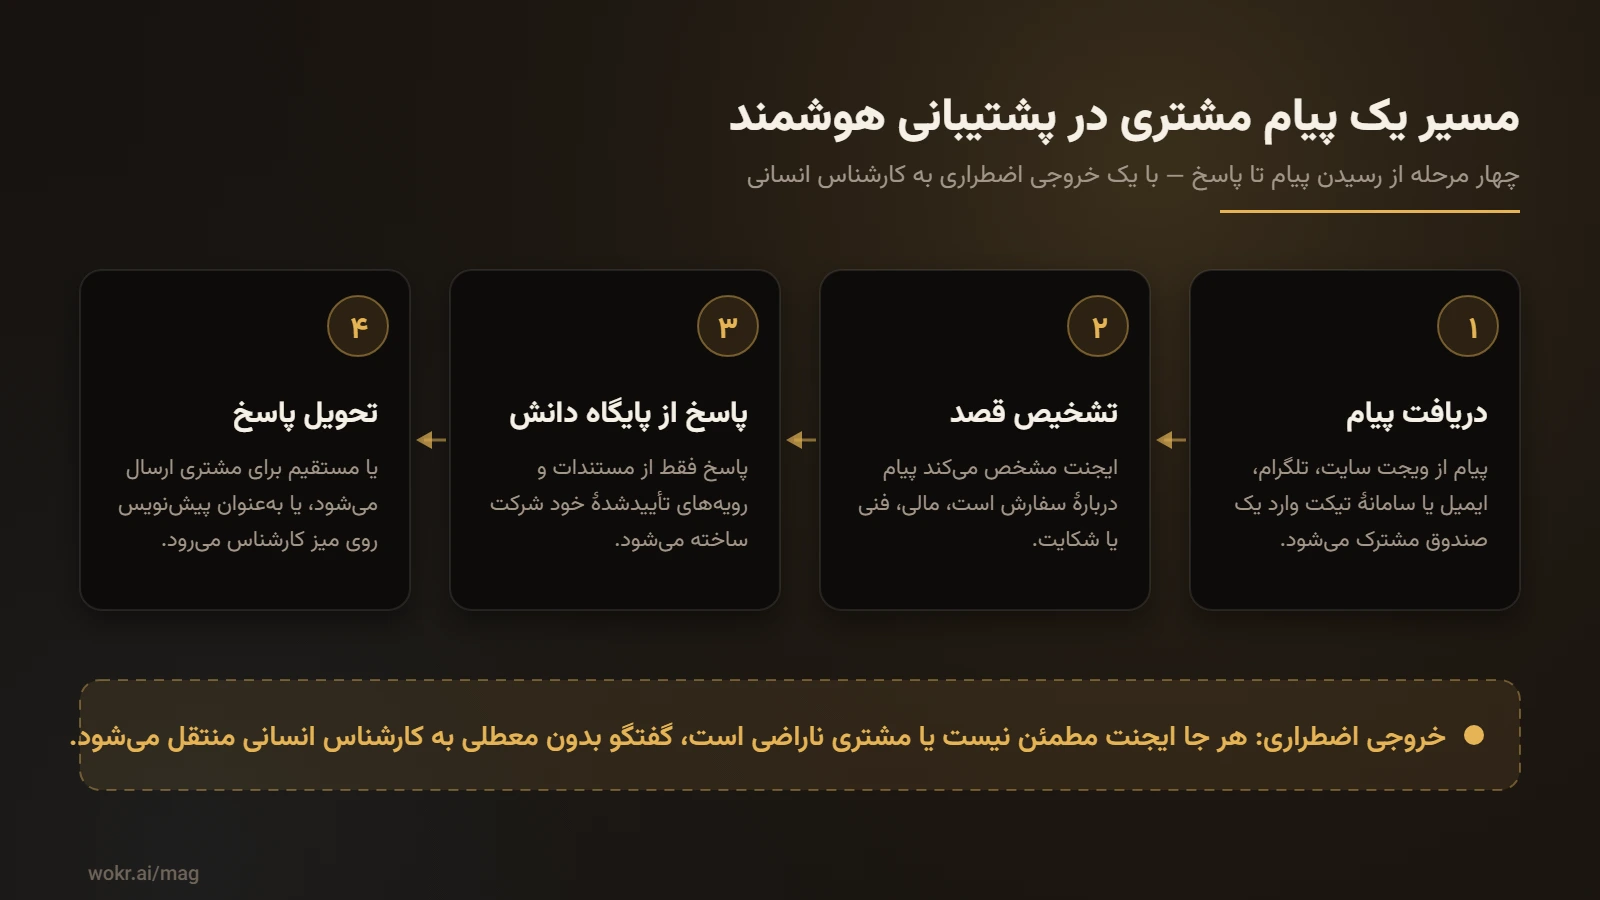
- لایهٔ گفتگو — همان چیزی که مشتری میبیند: ویجت سایت، پیامرسان یا سامانهٔ تیکت. کارش دریافت پیام و تحویل پاسخ است.
- لایهٔ دانش — منبعی که پاسخ از آن ساخته میشود: مستندات محصول، رویههای بازگشت کالا، شرایط گارانتی و سوابق سفارش. این همان چیزی است که در معماری RAG به مدل وصل میشود تا بهجای حدس زدن، از دادهٔ واقعی شما جواب بدهد.
- لایهٔ پشتصحنه — جایی که ایجنت هوش مصنوعی کار میکند: خواندن خروجی تیکتها، دستهبندی دلایل تماس، نوشتن پیشنویس پاسخ و ساختن گزارش. این لایه را مشتری هرگز نمیبیند، ولی بیشترین صرفهجویی در وقت تیم از همینجا میآید.
بیشتر شکستهای پروژههای «پشتیبانی هوشمند» از اینجا شروع میشود که سازمان فقط لایهٔ اول را میخرد. ویجت نصب میشود، اما چون به دانش واقعی شرکت وصل نیست، جوابهایی میدهد که یا کلیاند یا اشتباه.
چرا بیشتر چتباتها حس «رباتزدگی» میدهند؟
«رباتزدگی» یک مشکل زیباییشناختی نیست؛ نشانهٔ چند خطای طراحی کاملاً مشخص است:
- پاسخ از منبع اشتباه — ربات از دانش عمومی اینترنت جواب میدهد، نه از رویهٔ رسمی شرکت شما. نتیجه، پاسخی است که درست بهنظر میرسد ولی با واقعیت سازمان نمیخواند.
- نبود مسیر خروج — مشتری راهی برای رسیدن به آدم واقعی پیدا نمیکند و در حلقهٔ منوها گیر میافتد. این تنها موردی است که بهتنهایی میتواند کل تجربه را خراب کند.
- لحن ترجمهشده — جملات فارسیای که ساختارشان انگلیسی است و بوی ترجمهٔ ماشینی میدهند. حل این مورد به مدل بهتر ربطی ندارد؛ به پرامپتنویسی درست فارسی و تعریف صریح لحن برند مربوط است.
- بیخبری از وضعیت واقعی — رباتی که به سامانهٔ سفارش وصل نیست، هر چقدر هم روان حرف بزند نمیتواند بگوید بستهٔ مشتری کجاست.
- اصرار بر بستن گفتگو — سیستمی که برای «کاهش تیکت» تنظیم شده، ناخودآگاه یاد میگیرد مشتری را دستبهسر کند.
خبر خوب اینکه هر پنج مورد خطای پیکربندیاند، نه محدودیت فناوری. با تعریف روشن منبع دانش، قواعد ارجاع و لحن، هر پنج مورد قابل رفع است.
کدام بخش پشتیبانی را خودکار کنیم و کدام را نه؟
این مهمترین تصمیم پروژه است و متأسفانه معمولاً بر اساس «چقدر میشود خودکار کرد» گرفته میشود، نه «چقدر باید». معیار درست، هزینهٔ اشتباه است: هر جا یک پاسخ غلط برای مشتری هزینهٔ مالی یا حقوقی دارد، انسان باید در مسیر باشد.
| نوع درخواست | حالت پیشنهادی | دلیل |
|---|---|---|
| پیگیری سفارش و زمان ارسال | خودکار کامل | پاسخ از سامانه خوانده میشود؛ جای تفسیر ندارد. |
| پرسشهای تکراری دربارهٔ محصول | خودکار کامل | پاسخ ثابت است و در مستندات وجود دارد. |
| صدور فاکتور و مدارک | خودکار با قالب ثابت | خروجی استاندارد است؛ ساخت فاکتور رسمی را میتوان تمامخودکار کرد. |
| مغایرت مالی و درخواست بازپرداخت | پیشنویس + تأیید کارشناس | اشتباه در عدد، هزینهٔ مستقیم دارد. |
| شکایت و نارضایتی جدی | انسان پاسخ میدهد، ایجنت خلاصه میکند | مشتری عصبانی به همدلی نیاز دارد، نه سرعت. |
| مذاکره، تمدید یا فسخ قرارداد | فقط انسان | تعهد حقوقی ایجاد میکند. |
هر پاسخی که اشتباهبودنش برای مشتری هزینهٔ مالی یا حقوقی دارد، باید پیش از ارسال از چشم یک انسان بگذرد. بقیه را با خیال راحت خودکار کنید.
قاعدهٔ طلایی
چطور یک لایهٔ پشتیبانی هوشمند بسازیم؟
مسیر عملی پنج گام دارد و هیچکدام به تیم فنی بزرگ نیاز ندارد:
- پرتکرارترین پرسشها را استخراج کنید. خروجی تیکتها یا گفتگوهای سه ماه گذشته را بگیرید و ببینید ۲۰ پرسش اول چه سهمی از کل حجم دارند. تقریباً همیشه اقلیتی از پرسشها اکثریت بار را میسازند؛ کار را از همانها شروع کنید.
- یک پایگاه دانش تمیز بسازید. برای هر پرسش، یک پاسخ رسمی و بهروز بنویسید. کیفیت این متنها سقف کیفیت کل سیستم را تعیین میکند — هیچ مدلی نمیتواند از یک سند مبهم، پاسخ روشن بسازد.
- قواعد ارجاع را صریح بنویسید. مشخص کنید در چه شرایطی گفتگو بلافاصله به انسان منتقل میشود: کلمات مربوط به شکایت، درخواست بازپرداخت، تکرار پرسش، یا هر جا سیستم مطمئن نیست.
- دو هفته در حالت پیشنویس اجرا کنید. در این مرحله پاسخها مستقیم برای مشتری نمیرود؛ روی میز کارشناس مینشیند و او تأیید یا اصلاح میکند. این کار هم خطا را میگیرد و هم به شما نشان میدهد کدام دسته آمادهٔ خودکارسازی کامل است.
- هفتگی اندازه بگیرید و اصلاح کنید. یک گزارش هفتگی خودکار که نشان بدهد چه چیزی خودکار پاسخ داده، چه چیزی ارجاع شده و چرا، عملاً نقشهٔ راه بهبود ماه بعد شماست.
اگر فروشگاه اینترنتی دارید، این پنج گام تقریباً بدون تغییر قابل اجراست؛ نمونهٔ مفصلتر آن را در راهنمای هوش مصنوعی برای فروشگاه اینترنتی آوردهایم.
وکر در پشتیبانی مشتری کجا مینشیند؟
صادقانه بگوییم: وکر یک ویجت گفتگو برای سایت شما نیست. وکر در لایهٔ پشتصحنه کار میکند — همان لایهای که معمولاً نادیده گرفته میشود و بیشترین وقت تیم پشتیبانی را میبلعد. کارهای واقعی که میتوانید همین امروز به آن بسپارید:
- خروجی اکسل یا CSV تیکتهای ماه گذشته را بدهید و بخواهید دلایل تماس را دستهبندی کند و پرتکرارترینها را فهرست کند.
- از روی مستندات و رویههای داخلی، متن پاسخهای آماده و پایگاه دانش اولیه را بنویسد.
- برای موارد پیچیده، پیشنویس پاسخ با لحن یکدست برند تولید کند تا کارشناس فقط بازبینی کند.
- گزارش هفتگی وضعیت پشتیبانی را بسازد و روند شکایتها را نشان بدهد.
وکر روی وباپ، اپ ویندوز، افزونهٔ کروم و Wokr Code برای VSCode در دسترس است؛ برای تیم پشتیبانی معمولاً وباپ و اپ ویندوز کافی است. پلن رایگان ۱٬۰۰۰ توکن در هر ساعت میدهد و برای شروع به کارت بانکی نیاز ندارید، بنابراین میتوانید قبل از هر تصمیمی، همان فایل تیکتهای ماه گذشته را تست کنید. پرداخت هم ریالی و از طریق درگاه ایرانی انجام میشود و اعتبار خریداریشده تاریخ انقضا ندارد — یعنی اشتراک ماهانهٔ اجباری در کار نیست. جزئیات را در صفحهٔ قیمتها ببینید.
اگر سازمان بزرگتری دارید و میخواهید ایجنت اختصاصی پشتیبانی خودتان را بسازید یا دادهها از شبکهٔ داخلی خارج نشود، Agent Studio و استقرار on-premise در بخش سازمانی برای همین موارد است. پیش از هر اتصالی هم پیشنهاد میکنیم مرزهای امنیت داده را مشخص کنید: اطلاعات تماس و شمارهٔ کارت مشتریان جزو دادههایی نیستند که بیمحابا به هر ابزاری بدهید.
چطور بفهمیم پشتیبانی هوشمند جواب داده است؟
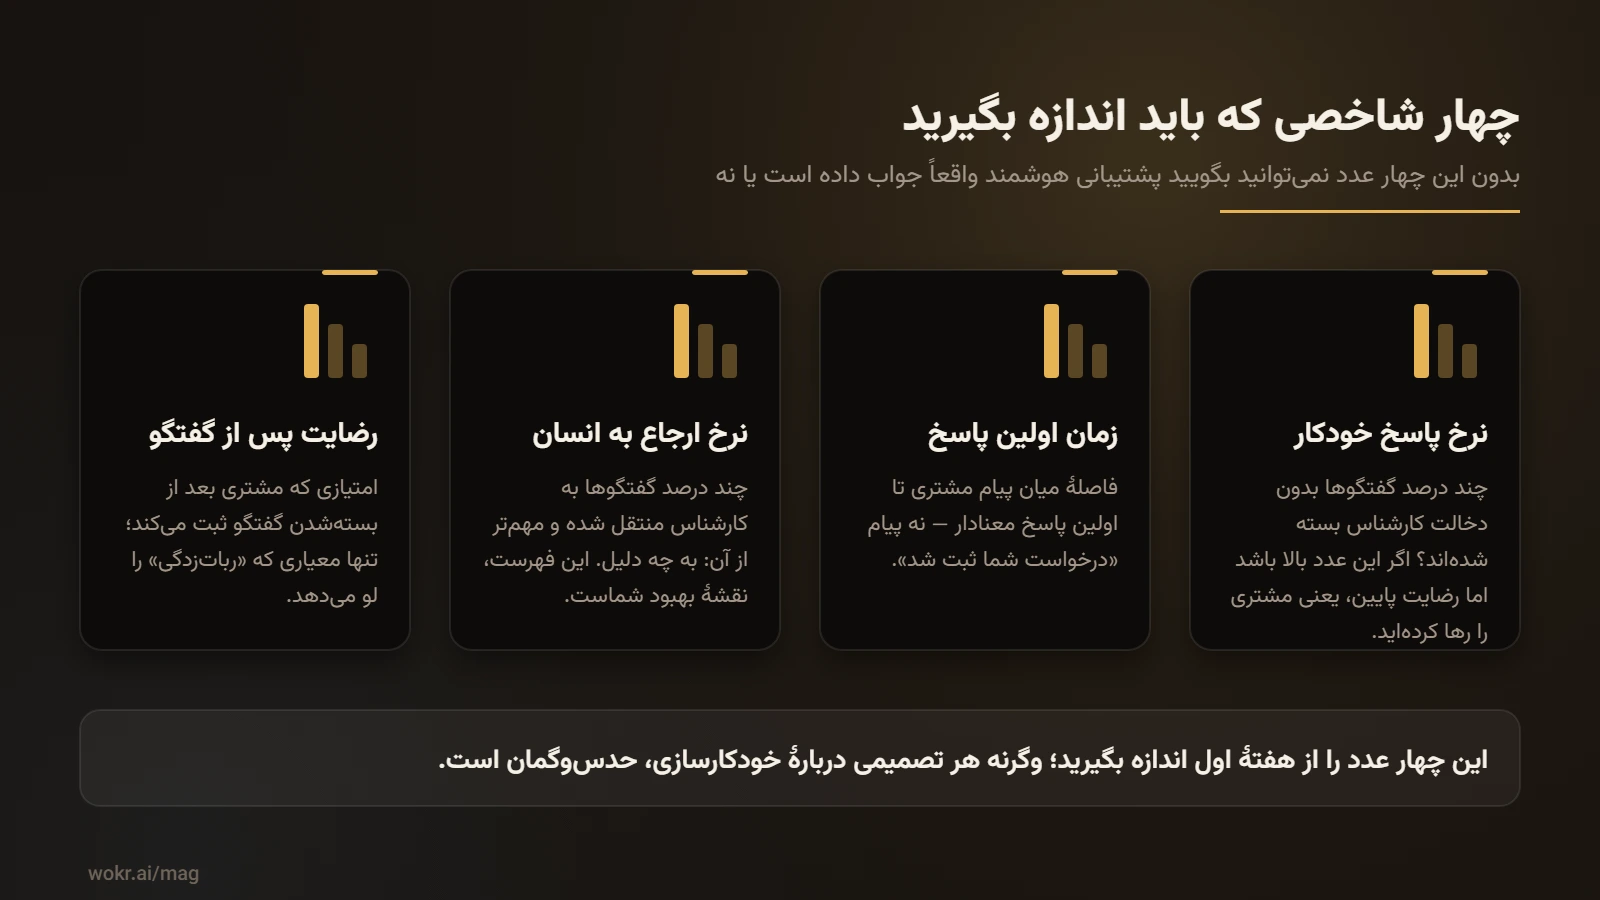
بدون عدد، این بحث به سلیقه تبدیل میشود. چهار شاخص کافی است و هر چهار را باید کنار هم خواند، نه جداگانه:
- نرخ پاسخ خودکار — چند درصد گفتگوها بدون دخالت کارشناس بسته شدهاند.
- زمان اولین پاسخ — فاصلهٔ پیام مشتری تا اولین پاسخ معنادار؛ پیام «درخواست شما ثبت شد» پاسخ حساب نمیشود.
- نرخ ارجاع به انسان — چند درصد به کارشناس رفته و مهمتر از عدد، دلیلش چه بوده.
- رضایت پس از گفتگو — امتیازی که مشتری بعد از بستهشدن گفتگو ثبت میکند.
خطای رایج این است که فقط نرخ پاسخ خودکار را هدف بگذارید. اگر این عدد بالا برود ولی رضایت پایین بیاید، سیستم شما مشتری را راضی نکرده — فقط خستهاش کرده تا برود. نسبت این دو شاخص به هم، صادقترین معیاری است که دارید.
پنج اشتباه رایج که باید از آنها دوری کنید
- پنهانکردن رباتبودن. مشتری در چند جمله میفهمد. شفاف بگویید دستیار هوشمند است و راه رسیدن به کارشناس را کنار آن نشان بدهید.
- راهاندازی همهچیز در یک روز. شروع با پنج دستهٔ پرتکرار، نتیجهٔ بهتری میدهد تا پوشش صددرصدی با کیفیت پایین.
- رها کردن پایگاه دانش. سندی که شش ماه بهروز نشده، ربات را به منبع اطلاعات غلط تبدیل میکند.
- حذف نیروی انسانی در گام اول. کاهش تیم پشتیبانی پیش از تثبیت شاخصها، ریسکی است که معمولاً با از دست دادن مشتری جبران میشود.
- نادیده گرفتن ساعات اوج. بیشترین ارزش پشتیبانی هوشمند در شب و تعطیلات است؛ اگر در آن ساعتها مسیر ارجاع به انسان بسته باشد، فقط نارضایتی را جابهجا کردهاید.
پرسشهای پرتکرار
آیا هوش مصنوعی جای تیم پشتیبانی را میگیرد؟
در عمل نه. چیزی که تغییر میکند ترکیب کار است: پرسشهای تکراری از میز کارشناس برداشته میشود و وقت او صرف مواردی میشود که به قضاوت، مذاکره یا همدلی نیاز دارند. تیمهایی که نتیجهٔ خوب گرفتهاند معمولاً تعداد نفرات را کم نکردهاند؛ سطح کاری که آن نفرات انجام میدهند را بالا بردهاند.
برای شروع چقدر داده لازم است؟
کمتر از چیزی که فکر میکنید. یک فایل خروجی از تیکتهای سه ماه گذشته و مجموعهٔ مستندات فعلی محصول، برای ساختن نسخهٔ اول کافی است. اگر مستندات مرتبی ندارید، همان بیست پاسخ پرتکراری که کارشناسانتان روزانه تایپ میکنند، نقطهٔ شروع خوبی است.
چطور مطمئن شویم لحن پاسخها فارسی و طبیعی میماند؟
با تعریف صریح لحن در دستورالعمل و بازبینی دورهای نمونهها. چند جملهٔ نمونه از بهترین پاسخهای کارشناسانتان بردارید و آنها را بهعنوان مرجع سبک بدهید؛ این کار از هر تنظیم فنی دیگری بیشتر اثر دارد.
دادههای مشتریان چه میشود؟
پیش از هر اتصالی مشخص کنید چه فیلدهایی اصلاً لازم نیست از سازمان خارج شود — معمولاً شمارهٔ کارت، کد ملی و آدرس کامل در این دستهاند. برای پاسخدادن به «سفارشم کجاست؟» فقط شمارهٔ سفارش و وضعیت آن کافی است، نه پروندهٔ کامل مشتری.
هزینهٔ شروع چقدر است؟
برای آزمایش اولیه صفر: پلن رایگان وکر ۱٬۰۰۰ توکن در هر ساعت میدهد و کارت بانکی نمیخواهد. اگر بعد از تست تصمیم گرفتید ادامه بدهید، اعتبار را ریالی و از درگاه ایرانی میخرید و آن اعتبار منقضی نمیشود.
جمعبندی
پشتیبانی مشتری با هوش مصنوعی وقتی نتیجه میدهد که آن را یک تصمیم طراحی ببینید، نه یک خرید نرمافزاری. سه لایه را کنار هم بگذارید — گفتگو، دانش و پشتصحنه — مرز روشنی بین کار خودکار و کار انسانی بکشید، دو هفته در حالت پیشنویس اجرا کنید و چهار شاخص را هفتگی بخوانید. همین چند تصمیم، فاصلهٔ میان پاسخ سریع و «رباتزدگی» را میسازد.
سادهترین نقطهٔ شروع این است: فایل تیکتهای ماه گذشته را در پلن رایگان وکر باز کنید و ببینید پرتکرارترین دلایل تماس مشتریانتان واقعاً چیست. تصمیم بعدی، بعد از دیدن آن فهرست خیلی راحتتر گرفته میشود.