یک کارشناس مالی برای اینکه سریعتر گزارش را ببندد، فایل اکسل صورتحساب مشتریان را — با نام، شمارهٔ تماس و مبلغ بدهی — در یک چتبات عمومی آپلود میکند. کار در پنج دقیقه تمام میشود. مسئله این است که هیچکس در سازمان نمیداند آن فایل کجا رفت، چقدر نگه داشته میشود و چه کسی به آن دسترسی دارد. این اتفاق در بیشتر شرکتها نه با تصمیم مدیریت، که با ابتکار شخصی یک کارمند عجول میافتد.
امنیت داده در هوش مصنوعی دقیقاً از همینجا شروع میشود: نه از رمزنگاری و فایروال، بلکه از این پرسش ساده که «چه چیزی اصلاً باید از سازمان خارج شود؟». در این مقاله مرز روشنی میکشیم بین دادهای که میتوانید با خیال راحت به یک ابزار هوش مصنوعی بدهید و دادهای که نباید؛ سه سطح طبقهبندی داده را مرور میکنیم؛ و میبینیم در چه شرایطی استقرار روی زیرساخت خودتان واقعاً لازم است و در چه شرایطی فقط هزینهٔ اضافی است.
امنیت داده در هوش مصنوعی یعنی چه؟
پاسخ کوتاه: یعنی کنترل بر سه چیز — اینکه داده کجا پردازش میشود، چه مدت نگه داشته میشود، و چه کسی میتواند به آن نگاه کند. هر بحث فنی دیگری زیرمجموعهٔ همین سه پرسش است.
تفاوت مهم با نرمافزارهای معمول این است که ابزارهای هوش مصنوعی «پردازشمحور» هستند، نه «ذخیرهمحور». شما لزوماً یک پایگاه داده به آنها نمیدهید؛ یک متن، یک فایل یا یک تصویر میفرستید تا کاری روی آن انجام شود. اما همان یک فایل هم در مسیر رفتوبرگشت روی سرورهایی مینشیند که مالکشان شما نیستید. وقتی ایجنت هوش مصنوعی وارد ماجرا میشود، دامنه بزرگتر هم میشود: ایجنت فقط متن تولید نمیکند، بلکه فایل باز میکند، به ابزارها وصل میشود و گاهی به سامانههای داخلی دسترسی میگیرد.
پس سؤال درست این نیست که «آیا هوش مصنوعی امن است؟» — سؤال درست این است که «کدام داده، در کدام ابزار، تحت چه قراری؟».
چه دادههایی را نباید به ابزار هوش مصنوعی بفرستید؟
اگر فقط یک بخش از این مقاله را به تیمتان منتقل میکنید، همین فهرست باشد. این موارد را در یک ابزار عمومی و بدون قرارداد سازمانی وارد نکنید:
- اطلاعات هویتی افراد: کد ملی، شمارهٔ شناسنامه، تصویر کارت ملی، آدرس منزل.
- دادهٔ مالی قابل انتساب به یک شخص: شمارهٔ کارت، شبا، گردش حساب، فهرست بدهکاران با نام.
- اعتبارنامههای فنی: کلید API، رمز پایگاه داده، توکن دسترسی، فایل تنظیمات سرور. اینها را حتی در قالب «فقط میخواهم این کد را دیباگ کنی» هم نفرستید.
- دادهٔ سلامت: پروندهٔ بیمار، نتیجهٔ آزمایش، تصویر رادیولوژی همراه با مشخصات فرد.
- اسرار تجاری و اسناد حقوقی امضاشده: قرارداد با طرفین واقعی، صورتجلسهٔ هیئتمدیره، ساختار قیمتگذاری محرمانه، اسناد در جریان دعوا.
- دادهٔ متعلق به مشتری شما: اگر پیمانکار هستید، دادهٔ کارفرما مال شما نیست که دربارهٔ خروجش تصمیم بگیرید.
نکتهٔ ظریف: بسیاری از این کارها با نیت بد انجام نمیشود. کسی که پروندهٔ کامل یک مشتری را برای خلاصهسازی آپلود میکند، فقط میخواهد کارش زودتر تمام شود. برای همین «ممنوع کردن» بهتنهایی جواب نمیدهد؛ باید یک مسیر مجاز و راحت جایگزینش کنید — چیزی که در بخش کمینهسازی داده به آن میرسیم. همین منطق در کار دفاتر حقوقی با هوش مصنوعی هم برقرار است، جایی که محرمانگی پرونده اصلاً قابل مذاکره نیست.
آیا دادهٔ من برای آموزش مدل استفاده میشود؟
این پرتکرارترین نگرانی است و پاسخش به سرویس بستگی دارد، نه به «هوش مصنوعی» بهطور کلی. سه حالت رایج وجود دارد: سرویسهایی که ورودی کاربران را برای بهبود مدل به کار میگیرند مگر آنکه خودتان غیرفعال کنید؛ سرویسهایی که در پلن سازمانی این کار را بهطور پیشفرض انجام نمیدهند؛ و استقرارهایی که اصلاً داده از محیط شما خارج نمیشود.
بهجای اعتماد به جملهٔ تبلیغاتی روی صفحهٔ اصلی، این چهار پرسش را کتباً از هر فروشنده بپرسید:
- ورودی و خروجی من چند روز نگهداری میشود و بعد از آن چه اتفاقی میافتد؟
- آیا دادهٔ من برای آموزش یا ارزیابی مدل استفاده میشود؟ اگر بله، چطور غیرفعالش کنم؟
- چه کسی در سمت شما میتواند محتوای درخواستهای من را ببیند و تحت چه شرایطی؟
- اگر حسابم را ببندم، دادههای قبلی حذف میشود یا فقط دسترسی من قطع میشود؟
اگر پاسخ مکتوبی به این چهار پرسش نگرفتید، فرض را بر بدترین حالت بگذارید و فقط دادهٔ سطح عمومی بفرستید. این سختگیری نیست؛ حداقل کاری است که یک مدیر باید انجام دهد.
دادهٔ سازمان را چطور طبقهبندی کنیم؟
یک سیاست امنیتی سیصفحهای که کسی نمیخواندش، از یک قاعدهٔ سهخطی که همه بلدند بیاثرتر است. سادهترین طبقهبندی کارآمد سه سطح دارد و میشود آن را در یک جلسهٔ نیمساعته با تیم جا انداخت.
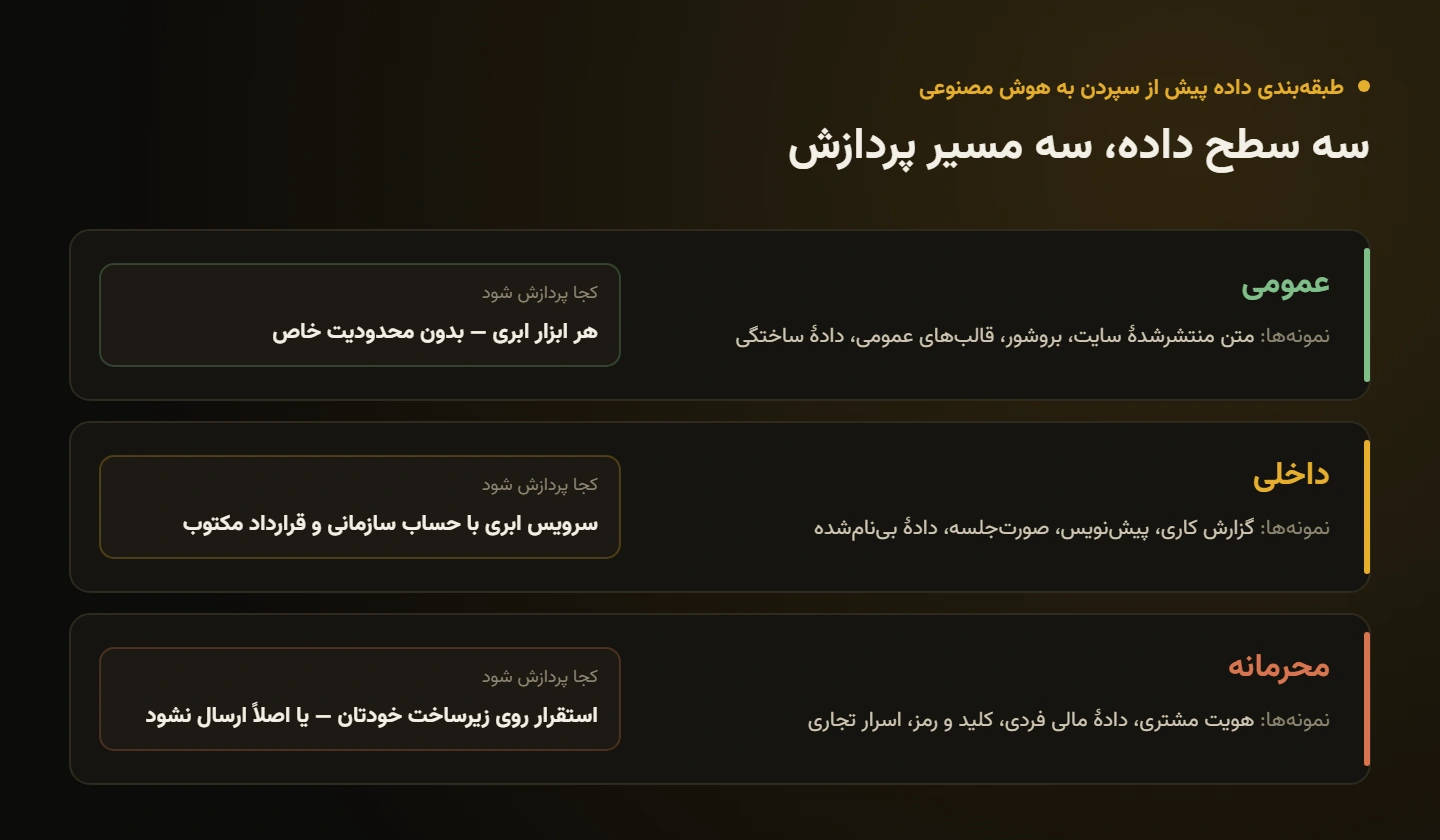
سطح عمومی شامل هر چیزی است که اگر فردا در سایت شما منتشر شود، اتفاقی نمیافتد: متن بروشور، توضیح محصول، قالبهای کاری، دادهٔ ساختگی. اینها را بدون نگرانی به هر ابزاری بدهید.
سطح داخلی شامل چیزهایی است که محرمانه نیستند اما دوست ندارید بیرون بروند: گزارشهای کاری، صورتجلسه، پیشنویسها، تحلیلهای تجمیعی. این سطح را روی حساب سازمانی و با قرارداد مکتوب پردازش کنید، نه با حساب شخصی کارمندان.
سطح محرمانه همان فهرست بخش قبل است. این سطح یا نباید از شبکهٔ شما خارج شود، یا باید پیش از خروج، شناسههایش حذف شود.
یک هشدار عملی: وقتی ایجنت را با روشهایی مثل RAG به آرشیو داخلی سازمان وصل میکنید، سطح دسترسی ایجنت خودبهخود برابر با سطح دسترسی همان مخزن میشود. اگر پوشهٔ اشتراکی شما مرتب نیست، ایجنت هم به اسنادی میرسد که نباید. مرتبکردن دسترسیها را قبل از اتصال انجام دهید، نه بعد از آن.
چطور بدون افشای هویت، از ایجنت کار بگیریم؟
در بیشتر کارهای روزمره، ایجنت اصلاً به نام واقعی افراد نیاز ندارد. برای محاسبهٔ معوقات، تحلیل الگوی خرید یا خلاصهسازی مکاتبات، «مشتری_۱» بهاندازهٔ نام واقعی کار میکند. روش استاندارد این است: پیش از ارسال، شناسهها را با برچسب موقت عوض کنید و بعد از دریافت خروجی، برچسبها را در سیستم خودتان به نام واقعی برگردانید.
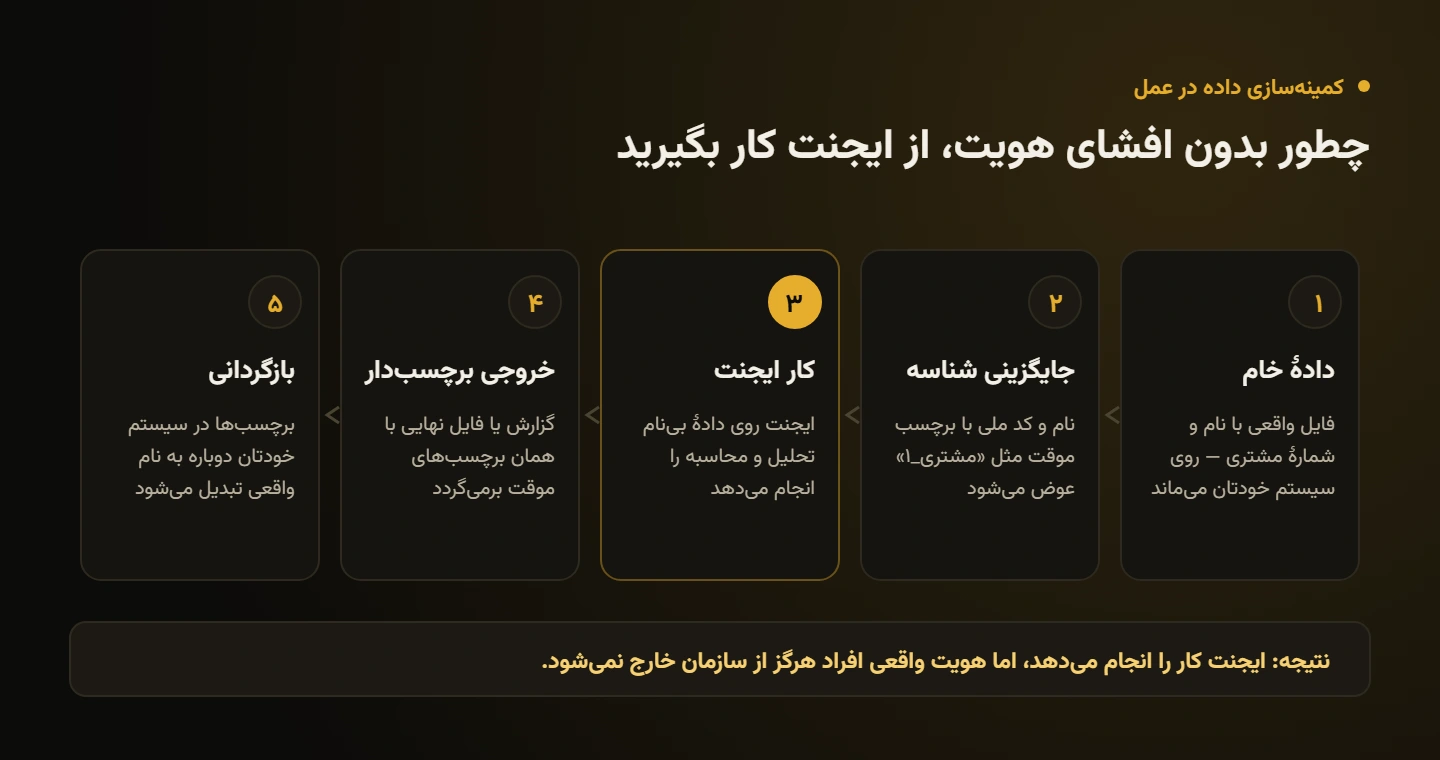
سه قاعدهٔ عملی که این کار را شدنی میکند:
- ستونهای غیرضروری را حذف کنید. پیش از آپلود اکسل، ستون نام و تلفن را پاک کنید. اغلب کل تحلیل بدون آنها هم انجام میشود.
- نمونه بفرستید، نه کل دیتابیس. برای اینکه ایجنت ساختار فایل را بفهمد، ده سطر کافی است.
- خروجی را هم بازبینی کنید. گاهی مدل شناسهای را که در متن پنهان بوده در خلاصه تکرار میکند. یک جستوجوی ساده در خروجی قبل از فوروارد کردن، کافی است.
در کارهایی مثل اتوماسیون کارهای اداری این روش تقریباً بدون هزینه است، چون فرمها و گزارشهای اداری معمولاً ساختار ثابتی دارند و حذف شناسه یک بار برای همیشه انجام میشود.
قاعدهٔ طلایی: پیش از ارسال هر دادهای بپرسید «اگر این فایل فردا عمومی شود، چه اتفاقی میافتد؟» اگر پاسختان چیزی جز «هیچ» بود، آن داده باید قبل از خروج بینام شود — یا اصلاً خارج نشود.
ابزار خارجی، سرویس ایرانی یا استقرار داخلی؟
انتخاب میان این سه، بیشتر از آنکه تصمیم فنی باشد، تصمیم دربارهٔ سطح داده است. جدول زیر تفاوتهای واقعی را کنار هم میگذارد — با همان ترتیبی که معمولاً برای یک شرکت ایرانی اهمیت دارد.
| معیار | ابزار ابری خارجی | سرویس ابری ایرانی | استقرار روی زیرساخت سازمان |
|---|---|---|---|
| محل پردازش داده | سرور خارج از کشور | سرور ارائهدهنده | شبکهٔ خودتان |
| مناسب برای کدام سطح | فقط عمومی | عمومی و داخلی | هر سه سطح |
| دسترسی پایدار از ایران | معمولاً نیازمند راهحل جانبی | مستقیم | مستقل از اینترنت بیرونی |
| روش پرداخت | کارت بینالمللی | ریالی با درگاه داخلی | قرارداد سازمانی |
| قرارداد و پاسخگویی حقوقی | شرایط استاندارد و غیرقابل مذاکره | قابل مذاکره | کاملاً در اختیار شما |
| زمان راهاندازی | چند دقیقه | چند دقیقه | هفتهها تا ماهها |
| هزینهٔ اولیه | ناچیز | ناچیز | قابل توجه |
برداشت عملی: استقرار داخلی برای همه لازم نیست. اگر دادههای محرمانهتان در چند فرایند مشخص متمرکز است، منطقیتر است همان چند فرایند را روی زیرساخت خودتان ببرید و بقیهٔ کارها را روی سرویس ابری انجام دهید. در وکر، این مسیر با Agent Studio و امکان استقرار on-premise برای سازمانها فراهم است؛ برای کارهای روزمره هم پلن رایگان با ۱٬۰۰۰ توکن در ساعت و بدون نیاز به کارت بانکی در دسترس است. اگر هنوز میان ابزار داخلی و خارجی مردد هستید، مقایسهٔ کاملتر را در جایگزین ایرانی ChatGPT بخوانید.
پنج اشتباه رایج که امنیت را از بین میبرد
- حساب شخصی بهجای حساب سازمانی. وقتی کارمند با ایمیل شخصیاش کار میکند، سازمان نه گزارشی دارد و نه امکان قطع دسترسی هنگام خروج او.
- قرار دادن کلید در متن درخواست. کلیدها را در متغیر محیطی نگه دارید و در نمونهکد جایگزین بیضرر بگذارید، مثل
API_KEY=xxxx. - ممنوع کردن بدون جایگزین. بخشنامهٔ «استفاده ممنوع» فقط استفاده را پنهان میکند؛ یک مسیر مجاز تعریف کنید.
- دادن دسترسی نوشتن به ایجنت از روز اول. اول فقط خواندن؛ بعد از چند هفته اعتماد، اجازهٔ تغییر.
- نداشتن مسئول مشخص. اگر یک نفر پاسخگوی سیاست هوش مصنوعی نباشد، سیاست عملاً وجود ندارد.
پرسشهای پرتکرار
آیا استفاده از هوش مصنوعی برای دادهٔ مشتریان قانونی است؟
بستگی به تعهدی دارد که خودتان به مشتری دادهاید. اگر در قرارداد یا سیاست حریم خصوصیتان گفتهاید داده را به شخص ثالث نمیدهید، ارسال آن به یک سرویس بیرونی نقض همان تعهد است. پیش از هر تصمیم فنی، متن قرارداد و سیاست حریم خصوصی خودتان را بازخوانی کنید.
آیا حذف چت، داده را هم پاک میکند؟
لزوماً نه. در بسیاری از سرویسها حذف گفتوگو فقط آن را از فهرست شما برمیدارد و نسخهٔ سمت سرور تا پایان دورهٔ نگهداری باقی میماند. عدد دقیق این دوره را باید از خود سرویس بپرسید.
برای یک شرکت دهنفره هم استقرار داخلی لازم است؟
معمولاً نه. برای تیمهای کوچک، ترکیب «حساب سازمانی + قاعدهٔ سهسطحی + بینامسازی داده» تقریباً همان نتیجه را با هزینهٔ بسیار کمتر میدهد. استقرار داخلی وقتی توجیه دارد که حجم قابل توجهی از کار روی دادهٔ محرمانه انجام شود یا الزام قراردادی مشخصی داشته باشید.
چطور جلوی آپلود فایل حساس توسط کارمندان را بگیریم؟
با سه کار ساده: یک فهرست یکصفحهای از «چه چیزی نه»، یک ابزار تأییدشدهٔ سازمانی که کار را راحتتر از راه غیرمجاز کند، و یک نفر مشخص که کارمند بتواند موارد مبهم را از او بپرسد. کنترل فنی بدون این سه، دور زده میشود.
آیا ایجنت میتواند بدون اینترنت کار کند؟
در حالت استقرار روی زیرساخت سازمان، پردازش داخل شبکهٔ شما انجام میشود و نیازی به خروج داده از سازمان نیست. در حالت ابری، ارتباط با سرویس لازم است. این تفاوت، اصلیترین دلیلی است که سازمانهای دارای دادهٔ محرمانه سراغ استقرار داخلی میروند.
جمعبندی
امنیت داده در هوش مصنوعی با خرید یک محصول حل نمیشود؛ با یک تصمیم ساده شروع میشود: دادهتان را به سه سطح تقسیم کنید، برای هر سطح یک مسیر مجاز تعیین کنید و آن مسیر را آنقدر راحت کنید که کسی وسوسه نشود از راه دیگری برود. بعد از آن، هر چیزی که به ایجنت میدهید یک انتخاب آگاهانه است، نه یک اتفاق.
اگر میخواهید این مسیر را برای سازمان خودتان پیاده کنید — از ایجنت اختصاصی با Agent Studio تا استقرار روی زیرساخت داخلی — صفحهٔ راهکارهای سازمانی وکر نقطهٔ شروع مناسبی است. برای امتحان کردن با دادهٔ غیرحساس هم میتوانید همین حالا و بدون کارت بانکی با پلن رایگان شروع کنید.